Analyse de documents par IA : ce qu’elle permet vraiment pour votre entreprise
L’intelligence artificielle permet aujourd’hui d’automatiser l’extraction, la structuration et la synthèse d’informations issues de documents variés, qu’il s’agisse de factures, de contrats ou de cahiers des charges. Les bénéfices sont concrets : gain de temps sur des tâches répétitives, décisions plus rapides et savoir métier mieux conservé. Encadrer ces usages reste toutefois indispensable, avec un contrôle humain systématique et une vigilance sur le RGPD et l’AI Act.
En bref:
- La fiabilité des outils d’IA pour l’analyse documentaire peut diminuer avec des documents très dégradés, manuscrits ou peu standardisés.
- La mise en place d’un protocole progressif, avec évaluation rigoureuse et contrôle humain, est essentielle pour garantir la qualité des résultats et limiter les risques.
- La conformité au RGPD exige une résidence européenne des données, des évaluations d’impact et un contrôle strict de la réutilisation des documents.
- Le choix d’un fournisseur doit s’appuyer sur la précision, la sécurité, l’intégration facile et le coût total, en réalisant un pilote sur un échantillon représentatif.
- L’association de l’analyse automatique et de la captation du savoir tacite par IA vocale permet de préserver et valoriser efficacement le savoir d’une entreprise.
Table des matières
- Que couvre l’analyse documentaire par IA : capacités et formats traités
- Cas d’usage concrets pour entreprises
- Approches techniques et architectures courantes
- Risques, conformité et bonnes pratiques
- Comment choisir et déployer une solution d’analyse documentaire IA
- Approche Skillsay : captation du savoir tacite et enrichissement documentaire par interview IA
- Perspective : intégrer l’analyse documentaire IA dans une stratégie de capitalisation du savoir
- Comment intégrer l’analyse documentaire IA dans une stratégie de capitalisation du savoir
- Comment Skillsay accompagne cette démarche
- Sources
- Questions fréquentes
Que couvre l’analyse documentaire par IA : capacités et formats traités
Avant de choisir un outil, il faut comprendre la distinction entre deux familles de documents. Les documents structurés (formulaires, tableaux, bases de données) suivent une organisation fixe que les logiciels traitent depuis longtemps. Les documents non structurés, eux, contiennent du texte libre, des images ou des mises en page variables : rapports, mails, plans techniques. C’est là que l’IA change la donne, en apportant une capacité de lecture et de compréhension que les outils classiques n’avaient pas.
Les fonctions les plus courantes s’articulent autour de plusieurs briques technologiques, chacune répondant à un besoin métier précis.
- La reconnaissance optique de caractères (OCR) transforme un document scanné ou une image en texte exploitable.
- La classification automatique trie les documents par type (facture, contrat, courrier) sans intervention manuelle.
- La reconnaissance d’entités nommées (NER) identifie noms, dates, montants ou références directement dans le texte.
- L’extraction de champs isole les informations précises attendues dans un formulaire ou un modèle de document.
- La vectorisation et la recherche sémantique permettent d’interroger une base documentaire par le sens plutôt que par mot-clé exact.
- La synthèse automatique condense un document long en quelques phrases utiles à la décision.
Selon Francenum, l’IA permet d’automatiser le dépouillement, la synthèse et l’extraction d’informations clés dans des documents complexes, ce qui réduit fortement le temps manuel requis. Les limites subsistent néanmoins sur les documents très dégradés, les plans techniques peu standardisés ou les écritures manuscrites, où la fiabilité de la lecture automatique reste variable.
Cas d’usage concrets pour entreprises
L’analyse documentaire par IA prend tout son sens quand elle s’attaque à des tâches répétitives et chronophages, celles qui pèsent sur des équipes déjà sollicitées ailleurs.
- Qualification d’appels d’offres. L’IA dépouille les documents de consultation et produit une fiche de synthèse permettant une décision rapide de type go ou no-go.
- Traitement des factures. L’extraction automatique des montants, références et échéances alimente directement les rapprochements comptables.
- Synthèse de cahiers des charges. Les exigences techniques dispersées dans des dizaines de pages sont isolées et regroupées pour un accès direct.
- Alimentation des workflows RH. Les documents liés à l’onboarding ou à l’offboarding nourrissent des bases de connaissances consultables par les équipes.
Le cas de l’entreprise Ingérop illustre bien la réalité du terrain. Selon les expérimentations rapportées par Francenum, l’IA peut produire des synthèses utiles pour qualifier des appels d’offres, mais cette confiance ne s’installe qu’avec un protocole d’évaluation rigoureux et un contrôle humain permanent. Le succès d’un projet d’automatisation documentaire dépend d’une approche progressive, avec des protocoles de test mesurant la constance et la répétabilité des résultats. Généraliser un usage sans preuve d’un bénéfice réel reste risqué, quel que soit l’enthousiasme initial.
Conseil de pro : commencez toujours par un lot de documents déjà traités manuellement, pour comparer les résultats de l’IA à une référence connue avant tout déploiement plus large.
Approches techniques et architectures courantes
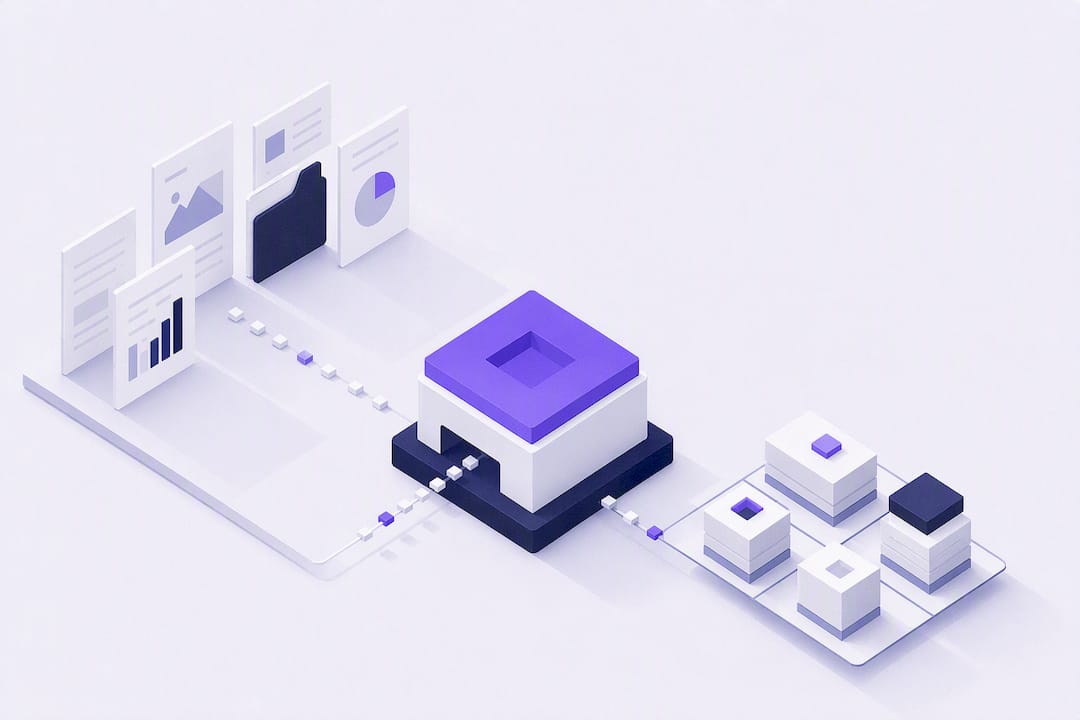
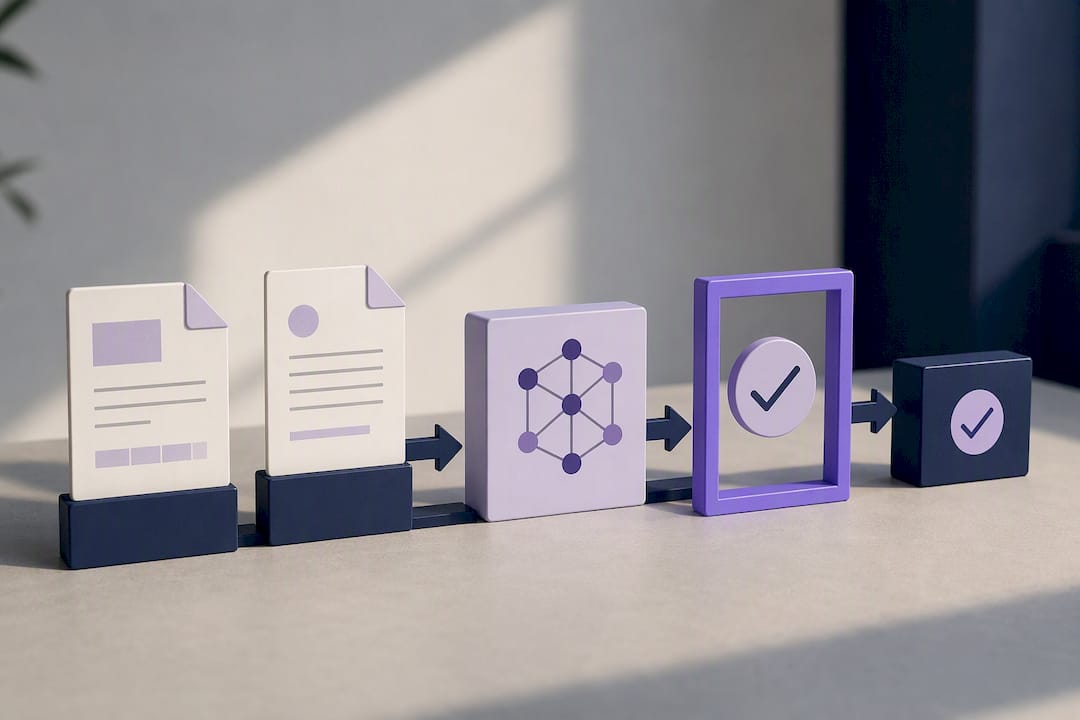
Comprendre les rouages techniques n’exige pas de devenir développeur, mais aide à poser les bonnes questions à un fournisseur. Un pipeline d’analyse documentaire suit généralement une séquence logique.
- L’ingestion récupère les documents depuis leur source, qu’il s’agisse d’un scanner, d’une boîte mail ou d’un système de gestion électronique.
- Le prétraitement et l’OCR nettoient et convertissent les documents en texte exploitable.
- L’extraction isole les champs et entités pertinents selon le cas d’usage.
- La vectorisation transforme le texte en représentations numériques exploitables par des modèles de recherche.
- L’indexation organise ces représentations pour permettre une recherche rapide.
- L’interface métier restitue les résultats aux équipes sous une forme directement utilisable.
Trois grandes familles de méthodes coexistent sur le marché. Les approches à base de règles restent efficaces sur des documents très standardisés, mais s’effondrent dès que la mise en page varie. Le machine learning supervisé apprend à partir d’exemples annotés et gagne en robustesse avec le volume de données d’entraînement. Les modèles profonds et génératifs, plus récents, traitent des documents non structurés avec une souplesse supérieure, au prix d’une plus grande exigence de gouvernance sur les données utilisées.
L’hébergement constitue un autre point d’attention majeur. Certaines solutions cloud proposent désormais des options de résidence des données en Union européenne, une réponse directe aux enjeux de souveraineté et de conformité que rencontrent les entreprises. C’est le cas de l’offre Document AI Workbench de Google Cloud, qui illustre cette tendance générique du marché vers des garanties de localisation. D’autres entreprises préfèrent un déploiement sur site, plus contraignant à mettre en œuvre mais offrant un contrôle direct sur le chiffrement et l’accès aux données.
Risques, conformité et bonnes pratiques
L’usage professionnel de l’IA documentaire ne peut pas faire l’impasse sur le cadre réglementaire, surtout quand des données personnelles circulent dans les documents traités. Le RGPD impose une base légale claire pour tout traitement de ce type, et la CNIL rappelle que les traitements d’IA doivent inclure une évaluation des risques et des mesures de transparence adaptées.
Certaines situations exigent d’aller plus loin. La CNIL recommande de documenter les données d’entraînement, d’évaluer les biais potentiels et, selon le niveau de risque identifié, de réaliser une analyse d’impact sur la protection des données avant tout déploiement à grande échelle.
Plusieurs mesures concrètes réduisent le risque pour une entreprise qui adopte ces outils.
- La résidence des données en Union européenne, exigée contractuellement auprès du fournisseur retenu.
- L’interdiction contractuelle de réutilisation des documents transmis pour entraîner d’autres modèles.
- La journalisation des échanges, prompts et résultats compris, pour assurer une traçabilité en cas de contrôle.
- Un plan de validation documenté, avec des jalons de contrôle humain avant toute automatisation complète d’un processus.
Les traitements d’IA impliquant des données personnelles doivent reposer sur une base légale et intégrer une évaluation des risques, selon les recommandations de la CNIL. Cette exigence ne relève pas d’une formalité administrative : elle protège l’entreprise autant que les personnes dont les données figurent dans les documents traités.
Le maintien d’un contrôle humain reste la garantie la plus solide contre les erreurs d’automatisation, particulièrement sur des décisions à enjeu financier ou juridique. Un document mal interprété par un modèle peut entraîner une facture erronée ou une clause contractuelle mal comprise, avec des conséquences bien réelles pour l’entreprise qui s’en remet trop vite à la machine.
Comment choisir et déployer une solution d’analyse documentaire IA
Le choix d’un fournisseur mérite une grille d’évaluation précise plutôt qu’une décision fondée sur une démonstration commerciale impressionnante. Plusieurs critères méritent d’être vérifiés avant toute signature.
- La précision d’extraction sur vos propres documents, testée avec un échantillon représentatif de votre activité réelle.
- La robustesse face à la variabilité de vos formats, mises en page et qualités de scan.
- Les garanties de sécurité, incluant chiffrement, résidence des données et politique de suppression.
- La facilité d’intégration avec vos systèmes d’information existants, sans développement lourd.
- Le support métier disponible, capable de comprendre vos processus et pas seulement la technique.
- Le coût total, licence comprise mais aussi temps d’intégration et de formation des équipes.
Un pilote bien construit repose sur un jeu de test représentatif, des métriques claires de rappel et de précision, un référent métier identifié côté entreprise et une durée définie à l’avance, généralement quelques semaines. Cette durée permet de mesurer la constance des résultats plutôt que de se fier à une démonstration isolée, forcément plus favorable qu’un usage réel prolongé.
Les clauses contractuelles négociées à ce stade conditionnent la sécurité de long terme du projet : interdiction de réutilisation des données pour l’entraînement d’autres modèles, engagements de niveau de service (SLA), droit d’audit et localisation garantie des données. Ces points, souvent négligés dans l’enthousiasme d’un premier essai, deviennent déterminants une fois le volume de documents traités multiplié par dix.
Approche Skillsay : captation du savoir tacite et enrichissement documentaire par interview IA
L’analyse documentaire automatique traite ce qui est déjà écrit. Mais une part considérable du savoir d’une entreprise ne l’est jamais : les astuces d’un technicien senior, le raisonnement d’un commercial face à un client difficile, les arbitrages d’un chef de projet expérimenté. Ce savoir tacite disparaît souvent au moment d’un départ, d’une retraite ou d’une cession, sans laisser de trace exploitable.
Skillsay s’attaque directement à ce manque grâce à Olivia, une IA vocale conçue pour interviewer les experts d’une entreprise et poser les questions qui font émerger ce qu’ils savent sans jamais l’avoir écrit. Cette captation vocale transforme des méthodes, des raisonnements et des pratiques métier en connaissances structurées, immédiatement interrogeables par les équipes.
Cette approche complète l’analyse documentaire automatique plutôt que de s’y substituer.
- L’offboarding devient un moment de capitalisation plutôt qu’une perte sèche de compétence.
- La génération de synthèses métier s’appuie sur des entretiens structurés plutôt que sur des notes éparses.
- L’enrichissement des bases documentaires combine documents existants et savoir capturé à la voix.
- Les agents IA interrogeables exploitent cette mémoire d’entreprise, alimentée en continu.
Cette méthode de capture du savoir tacite et son fonctionnement détaillé, de la captation à la restitution via le processus complet Skillsay, montrent une voie concrète pour sécuriser ce que les documents seuls ne révèlent jamais.
— quentin
Perspective : intégrer l’analyse documentaire IA dans une stratégie de capitalisation du savoir
Comment intégrer l’analyse documentaire IA dans une stratégie de capitalisation du savoir
La tentation la plus courante consiste à vouloir tout automatiser d’un coup, ce qui mène rarement à un résultat solide. Il vaut mieux démarrer par un cas d’usage précis, mesurable, et en tirer des enseignements avant d’étendre le périmètre.
Une gouvernance IA légère mais réelle fait toute la différence : un comité restreint, un référent métier identifié, des revues périodiques des résultats produits. Sans cette structure, les erreurs s’accumulent silencieusement jusqu’à ce qu’un incident les révèle brutalement.
Les indicateurs qui comptent restent simples : temps gagné sur les tâches concernées, volume de documents effectivement traités, taux d’adoption réel par les équipes plutôt que par la direction seule. Un outil puissant mais délaissé par les collaborateurs ne produit aucune valeur, quelle que soit la qualité de son moteur d’extraction.
— quentin
Comment Skillsay accompagne cette démarche
L’analyse documentaire automatique traite ce qui existe déjà par écrit, mais elle laisse de côté ce que vos experts savent sans jamais l’avoir formalisé. Skillsay comble précisément ce vide grâce à Olivia, l’IA vocale qui interviewe vos collaborateurs pour capturer méthodes, raisonnements et pratiques métier avant qu’ils ne disparaissent avec un départ ou une retraite.
Cette mémoire, une fois constituée, s’enrichit des documents, vidéos et audios de l’entreprise pour former une base interrogeable à tout moment, capable d’alimenter des agents IA métier au quotidien.
Le service interview vocale par IA en offboarding s’adresse aux entreprises qui veulent sécuriser un départ à venir, avec un tarif disponible sur le site Skillsay. La plateforme complète de knowledge management enrichie par l’IA est accessible via des abonnements mensuels, les prix actuels sont disponibles sur le site Skillsay. Une démonstration permet de voir concrètement comment Olivia capture ce savoir avant qu’il ne s’échappe.
Sources
Les points réglementaires et techniques de cet article s’appuient sur des sources primaires vérifiables. La CNIL détaille les conditions de licéité des traitements d’IA impliquant des données personnelles, ainsi que ses recommandations sur la documentation des systèmes d’IA. Francenum documente des retours d’expérimentation en entreprise, notamment sur le dépouillement d’appels d’offres et l’amélioration de la gestion documentaire. La documentation technique de Document AI Workbench illustre les options de résidence des données proposées par les grands fournisseurs cloud.
- Assurer que le traitement est licite (CNIL)
- Recommandations CNIL pour le développement des systèmes d’IA
- Document AI Workbench — options de résidence des données (Google Cloud)
Questions fréquentes
Quelle est la meilleure IA pour analyser des documents ?
Il n’existe pas d’outil universellement supérieur : le choix dépend du type de documents traités, du niveau de sécurité exigé et du degré d’intégration nécessaire avec vos systèmes existants. Les solutions cloud comme celles décrites par Document AI Workbench conviennent aux besoins génériques, tandis qu’un pilote sur vos propres documents reste la seule façon fiable de comparer les options.
Quelle IA peut lire un document ?
La plupart des solutions modernes combinent reconnaissance optique de caractères et modèles de compréhension du langage pour lire aussi bien des PDF scannés que des textes numériques natifs. La qualité de lecture varie fortement selon l’état du document d’origine et sa mise en page.
Quelle est la meilleure IA pour la synthèse de documents ?
Les modèles génératifs actuels produisent des synthèses utiles, mais leur fiabilité dépend d’un protocole de test rigoureux avant tout déploiement à grande échelle, comme le montrent les expérimentations rapportées par Francenum. Un contrôle humain reste recommandé sur les synthèses destinées à une décision importante.
Quelle IA gratuite puis-je utiliser pour analyser un texte ?
Plusieurs outils gratuits ou aux offres d’essai permettent une première analyse de texte, mais ils imposent souvent des limites de volume ou des garanties de confidentialité réduites. Pour un usage professionnel impliquant des données sensibles, mieux vaut vérifier les conditions de traitement des données avant tout envoi de documents réels.
Comment garantir la conformité RGPD d’un outil d’analyse documentaire ?
La conformité repose sur une base légale identifiée, une documentation des données utilisées et, selon le risque, une analyse d’impact sur la protection des données, comme le précise la CNIL. La résidence des données en Union européenne et l’interdiction contractuelle de réutilisation renforcent cette conformité.