RAG en entreprise : 5 POC prioritaires

Décideurs français : 5 POC RAG prioritaires, captez le savoir tacite
La RAG (retrieval-augmented generation, ou génération augmentée par récupération) permet à votre IA générative de répondre à partir de vos documents internes à jour, au lieu de puiser dans des connaissances génériques figées. Elle réduit les hallucinations, cite ses sources et coûte bien moins cher à mettre en place qu’un réentraînement complet de modèle. Le meilleur point de départ reste un projet pilote sur un cas d’usage précis, à fort retour attendu, plutôt qu’un déploiement généralisé d’emblée.
En bref:
- La qualité du corpus de documents, parfaitement structuré, nettoyé et à jour, est essentielle pour assurer la fiabilité des réponses générées par un système RAG.
- Le déploiement efficace commence souvent par un pilote ciblé sur un cas d’usage précis, avec des budgets allant de quelques milliers à plusieurs dizaines de milliers d’euros selon la portée.
- La gouvernance doit prévoir un contrôle strict des accès, un hébergement souverain et une traçabilité renforcée pour éviter les risques de fuite de données sensibles.
- La performance du RAG se surveille grâce à des métriques comme le rappel, la précision et la fidélité, complétées par un feedback utilisateur régulier.
- La captation préalable des connaissances tacites via des outils spécialisés optimise la qualité des données, prioritaire sur la sophistication du modèle LLM lui-même.
Table des matières
- Qu’est-ce que la RAG et comment elle fonctionne
- Quels sont les avantages et les limites réelles du RAG en entreprise
- Quels cas d’usage prioriser pour un premier projet RAG
- Comment déployer un RAG en entreprise étape par étape
- Vectordb, embeddings, LLM : quels choix technologiques privilégier
- Pourquoi le prétraitement des données fait toute la différence
- Gouvernance, sécurité et souveraineté : quelles précautions prendre
- Combien coûte un projet RAG et sur quel horizon
- Comment évaluer et maintenir la qualité d’un RAG dans le temps
- Perspective éditoriale : ce que révèlent les usages réels du RAG en entreprise
- Sources
Qu’est-ce que la RAG et comment elle fonctionne
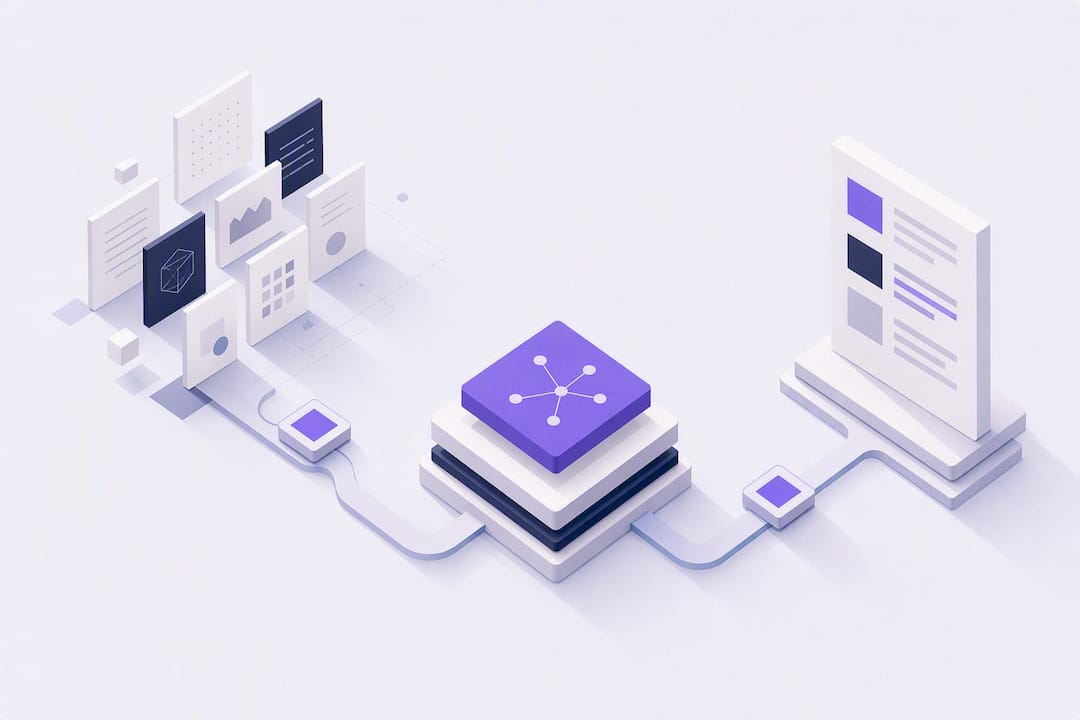
Un système RAG fonctionne en deux temps. D’abord la récupération : quand un collaborateur pose une question, le système va chercher dans votre base documentaire les passages les plus pertinents, pas le document entier. Ensuite la génération : le modèle de langage rédige une réponse en s’appuyant uniquement sur ces extraits, et non sur ses connaissances générales.
Concrètement, cette chaîne repose sur plusieurs briques. Les documents sont découpés en fragments (le fameux « chunking »), transformés en vecteurs numériques appelés embeddings, puis stockés dans une base vectorielle (vectordb). Au moment de la question, un moteur de recherche compare la requête à ces vecteurs pour identifier les passages les plus proches sémantiquement, parfois affinés par un reranker qui reclasse les meilleurs résultats. Un gabarit de prompt assemble ensuite ces extraits avant de les transmettre au LLM.
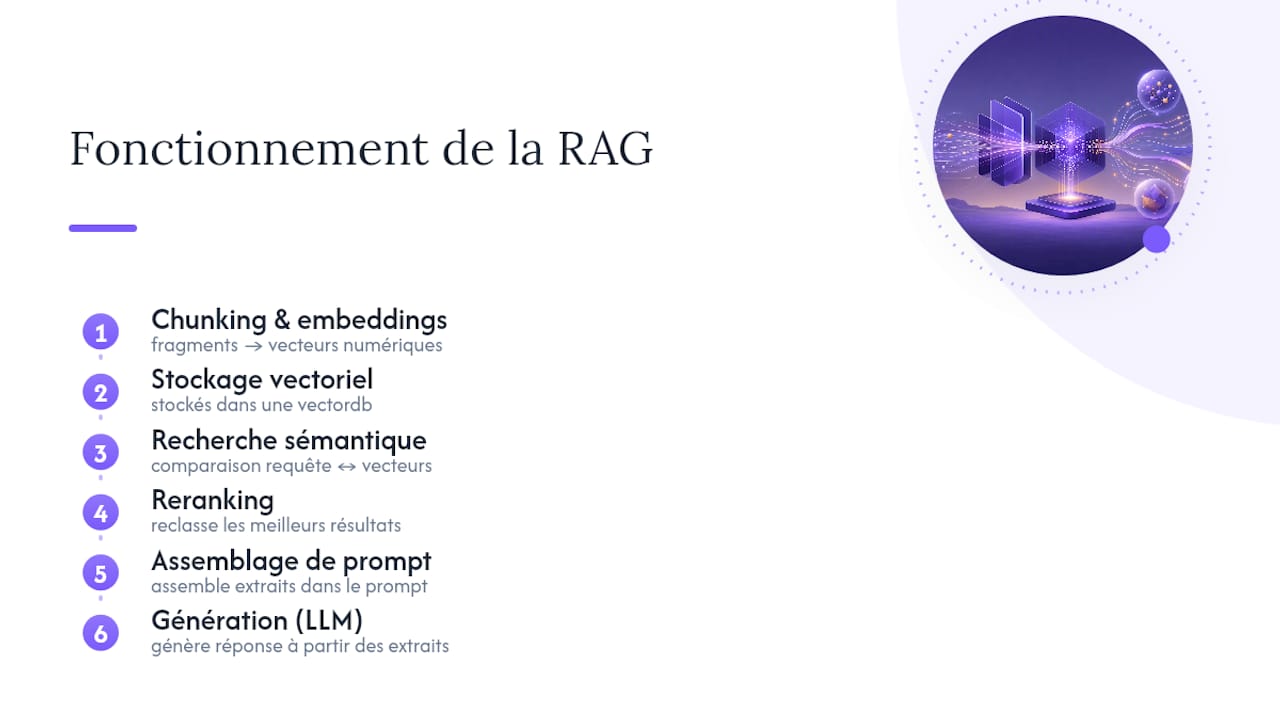
Prenons un exemple : un commercial demande « quelles sont nos conditions de garantie pour le client X ? ». Le système retrouve le contrat concerné, la grille tarifaire associée et la politique SAV en vigueur, puis génère une réponse qui cite précisément ces trois sources. C’est cette traçabilité qui distingue la RAG d’un simple chatbot génératif. La Direction générale des Entreprises souligne d’ailleurs que cette architecture connecte l’IA générative aux données internes tout en améliorant nettement la traçabilité des réponses produites.
Quels sont les avantages et les limites réelles du RAG en entreprise
Le bénéfice principal tient en une phrase : vos équipes obtiennent des réponses ancrées dans les documents réels de l’entreprise, avec la source citée à chaque fois. Cela change la donne pour la fiabilité perçue de l’IA en interne.
Les gains mesurables sont concrets :
- Réduction significative des hallucinations, puisque le modèle s’appuie sur des extraits vérifiables plutôt que sur sa mémoire générale.
- Mise à jour rapide des connaissances : ajouter un document récent suffit, sans réentraîner le modèle.
- Coût d’entrée nettement inférieur à un fine-tuning complet.
- Traçabilité des réponses, utile en audit ou en contexte réglementé.
Mais la RAG a ses limites. La latence augmente avec chaque étape de recherche ajoutée, et un corpus mal préparé produit des réponses médiocres même avec le meilleur modèle du marché. La maintenance de la base vectorielle demande une vigilance continue : documents obsolètes, doublons, versions contradictoires.
Deux risques méritent une attention particulière : la fuite de données sensibles si les droits d’accès ne sont pas correctement cloisonnés, et « l’effet démo », ce piège où le pilote impressionne sur dix questions choisies mais s’effondre en production sur la diversité réelle des usages.
Conseil de pro : Testez votre POC avec les questions les plus « sales » que vos équipes posent vraiment, pas celles qui valorisent le système. C’est là que vous verrez sa vraie robustesse.
Quels cas d’usage prioriser pour un premier projet RAG
Le choix du premier périmètre conditionne l’adhésion interne autant que le résultat technique. Un cas trop ambitieux épuise l’équipe projet avant de prouver sa valeur ; un cas trop anecdotique ne convainc personne.
- Support client de niveau 1 : indexez la FAQ, les tickets résolus et les fiches produits. KPI à suivre : temps de résolution moyen et taux d’escalade vers un humain.
- Onboarding et formation RH : indexez les procédures internes, guides métiers et comptes-rendus de formation. KPI : temps avant autonomie du nouvel arrivant, un cas d’usage que Skillsay traite directement via son module d’onboarding.
- Recherche juridique et conformité : indexez contrats types, clauses validées et jurisprudences internes. KPI : temps de recherche par dossier, taux d’erreur détecté en relecture.
- Génération de propositions commerciales : indexez anciennes offres gagnées, argumentaires et grilles tarifaires. KPI : temps de rédaction d’une offre, taux de conversion.
- R&D et veille technique : indexez brevets, notes d’essais et rapports de projets antérieurs. KPI : temps de recherche documentaire, réutilisation de travaux existants.
Le critère de sélection le plus fiable reste simple : choisissez le cas où le volume de documents est suffisant, où la fréquence de mise à jour est connue, et où un besoin de traçabilité existe déjà. C’est précisément la checklist que recommande France Num avant tout déploiement en PME ou ETI.
Comment déployer un RAG en entreprise étape par étape
Un projet RAG suit une progression assez standard, même si sa durée varie fortement selon l’ambition du périmètre. Les intégrateurs observent des budgets démarrant à quelques milliers d’euros pour un POC ciblé, contre plusieurs dizaines de milliers pour un déploiement complet en production.
- Cadrage : définir le cas d’usage, les utilisateurs cibles et les KPI de succès avant d’écrire une ligne de code.
- Audit des données : cartographier les sources disponibles, leur qualité, leur fraîcheur et leur sensibilité.
- Ingestion et préparation : nettoyer, structurer et découper les documents en fragments exploitables.
- Tests et itérations : confronter le système à des questions réelles, mesurer les écarts, ajuster le chunking ou le prompt.
- Industrialisation : sécuriser les accès, monitorer les performances, planifier la maintenance continue.
Les timelines diffèrent nettement selon l’étape visée. Un POC sur un périmètre restreint peut généralement se boucler rapidement. Un projet complet avec intégration aux systèmes existants, gouvernance formalisée et déploiement à l’échelle de plusieurs services s’étale généralement sur plusieurs mois.
Cette feuille de route mobilise des rôles distincts, souvent négligés dans les plannings initiaux :
- Les équipes métier, qui valident la pertinence des réponses et fournissent les cas de test réels.
- La DSI, responsable de l’intégration technique et de la performance du système.
- La sécurité informatique, qui définit les règles d’accès et audite les flux de données.
- Un référent gouvernance, chargé de documenter les usages autorisés et de trancher les zones grises.
Vectordb, embeddings, LLM : quels choix technologiques privilégier
Le choix de la base vectorielle dépend surtout de la sensibilité de vos données. Une solution self-hébergée offre un contrôle total sur la localisation des données, ce qui compte particulièrement pour des documents confidentiels ou réglementés. Une solution en mode SaaS accélère la mise en œuvre mais implique de confier vos vecteurs à un tiers, même si ceux-ci ne contiennent pas le texte brut.
Plusieurs critères doivent guider l’arbitrage technique :
- Qualité des embeddings : un modèle d’embedding mal adapté à votre langue ou votre vocabulaire métier dégrade la pertinence du retrieval avant même que le LLM n’entre en jeu.
- Latence vs performance du LLM : un modèle plus puissant répond souvent mieux, mais plus lentement. Pour un usage support en temps réel, ce compromis pèse lourd.
- Confidentialité du LLM : certains modèles hébergés à l’étranger posent des questions de souveraineté ; un hébergement en France reste préférable pour les données stratégiques.
- Recherche hybride : combiner recherche vectorielle et recherche par mots-clés classique (BM25) améliore souvent la pertinence sur des corpus hétérogènes, où certains termes techniques ou noms propres échappent à la seule similarité sémantique.
Les guides techniques d’implémentation convergent d’ailleurs sur ce dernier point : la recherche hybride est devenue un standard de fait sur les corpus mixtes, mêlant contrats, comptes-rendus et documentation technique. Snowflake note également que cette architecture reste nettement plus économique qu’un réentraînement complet du modèle, tout en conservant une traçabilité que le fine-tuning seul ne permet pas.
Pourquoi le prétraitement des données fait toute la différence
La qualité d’un RAG dépend d’abord de la qualité des documents qu’on lui donne à manger. Un corpus mal nettoyé, avec des versions obsolètes ou des doublons, produit des réponses incohérentes même avec le meilleur LLM disponible.
Trois pratiques structurent un prétraitement solide :
- Nettoyage préalable : supprimer les versions périmées, harmoniser les formats, éliminer les documents contradictoires avant l’ingestion.
- Chunking adapté au type de document : un contrat juridique se découpe par clause, un manuel technique par section, une FAQ par question. Un découpage uniforme et mécanique dégrade la pertinence du retrieval.
- Métadonnées enrichies : associer à chaque fragment sa date, sa version, son département d’origine et son niveau de confidentialité facilite le filtrage et la traçabilité des réponses.
Cette étape représente souvent la majorité du travail projet, bien plus que le réglage fin du modèle de langage. C’est aussi l’un des angles morts les plus fréquents dans les projets qui échouent : on optimise le LLM alors que le problème vient du corpus.
Conseil de pro : Avant de lancer l’ingestion, faites relire un échantillon de documents par les équipes métier concernées. Elles repèrent en quelques minutes les incohérences qu’un data scientist mettrait des semaines à identifier.
Gouvernance, sécurité et souveraineté : quelles précautions prendre
Un système RAG donne accès à l’ensemble de votre mémoire documentaire. Sans cloisonnement, un stagiaire peut se retrouver à interroger les mêmes contrats confidentiels qu’un directeur financier.
Trois piliers structurent une gouvernance solide :
- Contrôle d’accès dynamique : les droits de lecture doivent refléter la hiérarchie organisationnelle existante, pas une base ouverte à tous par défaut.
- Hébergement souverain : pour les données stratégiques ou réglementées, privilégiez un hébergement en France ou en Union européenne, condition de plus en plus attendue par les directions juridiques et les clients eux-mêmes.
- Traçabilité des usages : documenter qui interroge quoi, et pourquoi, protège l’entreprise en cas de contrôle et facilite l’amélioration continue du système.
Cette rigueur n’est pas une option pour convaincre un comité de direction frileux. Elle conditionne directement la capacité du projet à passer du pilote à la production sans incident.
Combien coûte un projet RAG et sur quel horizon
Les ordres de grandeur varient fortement selon l’ambition du périmètre. Un pilote ciblé sur un cas d’usage démarre souvent avec un budget de quelques milliers d’euros, tandis qu’un déploiement complet en production avec intégration aux systèmes existants grimpe à plusieurs dizaines de milliers d’euros.
Les coûts récurrents pèsent aussi dans le calcul : hébergement de la base vectorielle, appels API au LLM, et maintenance continue du corpus documentaire. Ces charges augmentent avec le volume de requêtes et la fraîcheur exigée des données.
Trois indicateurs permettent de juger objectivement le retour sur investissement :
- Temps de recherche économisé par requête, comparé à une recherche manuelle dans les dossiers existants.
- Taux de satisfaction des utilisateurs finaux sur un échantillon de questions réelles.
- Fidelity, c’est-à-dire la fidélité des réponses générées aux sources citées, mesurée sur un jeu de test métier.
Les entreprises qui capitalisent sur leur savoir interne via ce type d’outil peuvent réaliser des économies de temps de travail significatives par employé et par semaine, ce qui illustre le potentiel de gain une fois le système correctement calibré.
Comment évaluer et maintenir la qualité d’un RAG dans le temps
Un système RAG n’est jamais figé. Les documents évoluent, les usages changent, et sans surveillance active, la qualité des réponses se dégrade progressivement.
Les métriques essentielles à suivre en continu incluent :
- Recall@K : la capacité du système à retrouver les bons documents parmi les premiers résultats proposés.
- Précision : la proportion de documents retrouvés qui sont réellement pertinents pour la question posée.
- Fidelity : le degré de fidélité de la réponse générée aux extraits sources, sans invention ni déformation.
Au-delà des métriques automatiques, une boucle de feedback utilisateur reste indispensable : un simple bouton « cette réponse était-elle utile ? » remonte des signaux précieux pour ajuster le chunking ou enrichir le corpus. Un reporting qualité mensuel, partagé avec les équipes métier concernées, permet de détecter la dérive avant qu’elle n’affecte durablement la confiance des utilisateurs.
Perspective éditoriale : ce que révèlent les usages réels du RAG en entreprise
La plupart des articles sur la RAG survendent la technologie et sous-estiment le travail de préparation des données. C’est l’inverse qui devrait se produire. Un LLM médiocre sur un corpus propre surpasse presque toujours un LLM excellent sur un corpus mal structuré.
C’est précisément là que Skillsay change la donne : la plateforme capture le savoir tacite des collaborateurs par interview vocale, avant même qu’il ne devienne un document à ingérer. Les entreprises qui l’utilisent constatent une accélération notable du temps de formation des nouvelles recrues, ce qui indique que la qualité de la source prime sur la sophistication du modèle. Lors d’un départ de collaborateur clé, cette captation en amont dérisque considérablement le projet RAG qui suivra.
Le vrai levier n’est donc pas le choix du LLM. C’est la discipline apportée à la matière première qu’on lui donne.
— quentin
Sources
Avant même de choisir une base vectorielle, la question qui détermine tout le reste est simple : votre savoir interne est-il capturé, structuré et à jour ? Skillsay répond précisément à ce problème en amont de tout projet RAG. La plateforme capture le savoir-faire tacite de vos collaborateurs grâce à des agents vocaux qui les interviewent, et analyse automatiquement vos documents, audios et vidéos existants pour structurer ce savoir en temps réel.
Contrairement à une base documentaire figée, cette approche garantit un corpus propre, sourcé et interrogeable dès le départ, exactement ce dont un système RAG a besoin pour produire des réponses fiables. Découvrez comment fonctionne Skillsay de la captation à la restitution, ou explorez la capture audio et vidéo pour transformer le savoir de vos experts en actif exploitable sans qu’ils aient à rédiger une seule ligne. Demandez une démonstration pour évaluer, sur votre propre périmètre, à quelle vitesse votre base de connaissances peut devenir prête pour un projet RAG.
- Guide de la génération augmentée par récupération (RAG)
- Génération augmentée par récupération (RAG) — France Num
- Qu’est-ce que la RAG ? Guide complet — Snowflake
Recommandations