RGPD et IA générative : ce que les dirigeants doivent vérifier en 2026
Oui, le RGPD s’applique souvent à l’IA générative : dès qu’un modèle ou un système mémorise, traite ou permet d’extraire des données personnelles, le texte européen entre en jeu. La première tâche consiste à identifier votre rôle, déployeur ou fournisseur, puis à lancer sans attendre trois chantiers : la cartographie des traitements, une charte d’usage assortie de mesures de filtrage, et une analyse d’impact ou une vérification du statut du modèle utilisé.
En bref:
- Le RGPD s’applique à toute IA générative traitant ou mémorisant des données personnelles, avec des échéances importantes en 2026 et 2027 pour la conformité.
- Les déployeurs doivent établir une gouvernance interne, filtrer les données saisies, et coopérer avec les fournisseurs pour garantir la conformité de leurs systèmes.
- La documentation de provenance et des tests de réidentification est cruciale, tout comme la conservation des preuves dans un registre unique et daté pour faciliter la traçabilité.
- Les entreprises hébergeant l’IA hors UE doivent formaliser des garanties via des clauses contractuelles types pour respecter le transfert international de données.
- Il est aussi essentiel d’intégrer la transparence sur le contenu généré par l’IA, en informant clairement les utilisateurs, et de sécuriser l’ensemble des flux et des journaux pour prévenir les violations.
Table des matières
- Les textes et échéances clés à connaître
- Déployeur ou fournisseur : qui porte quelles obligations
- Sélectionner et documenter les données d’entraînement sans enfreindre le RGPD
- Construire une AIPD adaptée aux projets d’IA générative
- Transferts hors UE et transparence du contenu généré
- Sécurité opérationnelle et tenue des journaux
- Feuille de route priorisée pour une mise en conformité rapide
- Documenter ses preuves : le rôle de la capture du savoir tacite
- Données sensibles et catégories particulières dans l’entraînement
- Qui porte la responsabilité en cas de violation de données par l’IA
- Ce que montrent des cas concrets d’usage d’outils d’IA générative
- Interopérabilité et portabilité des données produites par l’IA
- Regarder au-delà de 2026 : ce qui va probablement se durcir
- Documenter sa conformité sans y passer des mois
- Sources
- Questions fréquentes
Les textes et échéances clés à connaître
Le RGPD ne fait aucune exception pour l’intelligence artificielle : il s’applique dès qu’un traitement de données personnelles intervient, que ce soit à l’entraînement, à l’usage ou à la sortie d’un modèle. La CNIL propose une méthodologie pour déterminer si un modèle entre dans ce champ, en s’appuyant notamment sur des tests d’attaques destinés à estimer la vraisemblance de réidentification des données mémorisées.
Ce cadre se double désormais du règlement européen sur l’IA, dont le calendrier structure les prochaines échéances pour les entreprises françaises. Le calendrier de mise en œuvre de la législation de l’UE sur l’IA fixe plusieurs jalons :
- 2 août 2026 : entrée en application de plusieurs obligations de transparence, dont celles qui concernent le contenu généré par l’IA.
- 2 décembre 2026 : nouvelles interdictions et périodes de transition pour certaines catégories de systèmes.
- 2 août 2027 : entrée en vigueur des règles applicables aux systèmes d’IA à haut risque.
En France, plusieurs autorités se répartissent la surveillance de ce nouveau paysage réglementaire. La CNIL reste l’interlocuteur naturel pour tout ce qui touche aux données personnelles, tandis que le Comité européen de la protection des données (CEPD) harmonise les positions à l’échelle de l’Union. Le Bureau de l’IA, rattaché à la Commission européenne, pilote l’application du règlement sur l’IA, et l’ANSSI complète ce dispositif en publiant des recommandations de sécurité technique pour les systèmes intégrés aux infrastructures des entreprises. Pour un dirigeant, retenir ces quatre noms suffit déjà à savoir où chercher une réponse fiable.
Déployeur ou fournisseur : qui porte quelles obligations
La plupart des entreprises françaises qui utilisent un assistant conversationnel ou un générateur de contenu sont des déployeurs : elles intègrent un modèle existant dans leurs processus sans l’avoir entraîné elles-mêmes. Un fournisseur, à l’inverse, développe ou entraîne le modèle, qu’il le commercialise ensuite ou l’intègre dans son propre service. Cette distinction change radicalement la nature des preuves à produire.
- Le déployeur met en place une gouvernance interne : charte d’usage opposable aux équipes, filtrage des données saisies dans les invites, information claire des utilisateurs finaux et coopération active avec le fournisseur pour obtenir sa documentation technique.
- Le fournisseur doit démontrer, avec des preuves techniques, la conformité de son modèle : documentation des données d’entraînement, tests d’attaques pour évaluer le risque de réidentification, et mesures de mitigation comme le bruitage ou le filtrage des sorties.
- Les deux rôles partagent une obligation de traçabilité continue, car un déployeur ne peut se contenter de faire confiance à son fournisseur sans exiger de garanties écrites.
Une PME qui utilise un assistant IA pour rédiger des comptes-rendus internes reste déployeur, même si elle personnalise fortement les invites. Elle doit néanmoins s’assurer qu’aucune donnée sensible ne transite vers un service tiers sans base légale claire.
Sélectionner et documenter les données d’entraînement sans enfreindre le RGPD
Le moissonnage de données sur le web pour entraîner ou affiner un modèle reste l’une des zones les plus scrutées par les régulateurs. Le CEPD rappelle que cette pratique est strictement encadrée par le RGPD, ce qui impose de documenter la provenance, la date de collecte et la légitimité de chaque source utilisée.
- Horodater chaque source de données collectée, pour prouver à quel moment et dans quel contexte elle a été récupérée.
- Conserver une preuve d’origine pour chaque jeu de données, qu’il s’agisse d’un contrat de licence, d’une autorisation explicite ou d’une source publiquement accessible sous conditions claires.
- Documenter le contrôle qualité appliqué avant intégration, notamment la détection de données personnelles non pertinentes pour l’usage prévu.
- Annoter les jeux de données selon les recommandations des fiches pratiques de la CNIL, qui insistent sur la nécessité de documenter et de sécuriser chaque étape de constitution du corpus.
Les tests de réidentification méritent une attention particulière : ils consistent à vérifier, par des attaques simulées, si un modèle peut restituer des informations personnelles présentes dans son corpus d’entraînement. La CNIL recommande de documenter ces tests de façon reproductible, avec leurs résultats et les mesures correctives appliquées en cas d’échec.
Conseil de pro : conservez chaque preuve de provenance dans un registre unique et daté, plutôt que dispersée entre plusieurs équipes : c’est souvent ce document qui manque le jour d’un contrôle.
Construire une AIPD adaptée aux projets d’IA générative
L’analyse d’impact relative à la protection des données (AIPD) doit être lancée dès la phase de cadrage d’un projet d’IA générative, avant tout déploiement en production. La CNIL détaille cette approche par la conception dans ses fiches pratiques consacrées au développement des systèmes d’IA.
- Cartographier les finalités précises du traitement et les catégories de données concernées, y compris celles saisies par les utilisateurs dans leurs invites.
- Évaluer les risques pour les personnes concernées, en particulier le risque de mémorisation involontaire de données sensibles.
- Documenter les mesures techniques retenues : minimisation des données transmises au modèle, pseudonymisation en amont, limitation de la longueur ou du contenu des sorties, filtrage automatique des réponses.
- Formaliser les preuves attendues par la CNIL : rapport d’AIPD daté, résultats des tests de mitigation, et registre des décisions prises.
La CNIL recommande d’intégrer la protection des données dès la conception des systèmes d’IA, une exigence qui structure directement le calendrier de toute AIPD sérieuse selon les fiches pratiques CNIL. Un projet lancé sans cette étape s’expose à devoir tout reprendre après coup, ce qui coûte toujours plus cher qu’une anticipation dès la conception.
Transferts hors UE et transparence du contenu généré
De nombreux outils d’IA générative sont hébergés hors de l’Union européenne, ce qui active les règles de l’article 44 du RGPD sur les transferts internationaux. Un transfert reste possible, mais uniquement encadré par des garanties appropriées.
- Clauses contractuelles types signées avec le fournisseur du service hébergé hors UE, précisant les engagements de protection des données.
- Vérification du niveau de protection offert par le pays de destination avant toute mise en production.
- Information des personnes concernées lorsque leurs données transitent vers un hébergeur extra-européen, dans le cadre habituel du registre des traitements.
En parallèle, l’obligation de transparence prévue par l’article 50 du règlement sur l’IA impose d’indiquer clairement aux personnes qu’elles interagissent avec un système d’IA. Les lignes directrices de la Commission européenne sur ces obligations précisent l’attente d’un marquage lisible, y compris par des moyens techniques, pour tout contenu généré artificiellement.
Sécurité opérationnelle et tenue des journaux
L’intégration d’un système d’IA générative dans le système d’information d’une entreprise change la surface de risque, et l’ANSSI en tire des conséquences concrètes. Ses recommandations de sécurité pour un système d’IA générative appellent à une posture de prudence dès l’intégration, plutôt qu’à des correctifs après incident.
- Isoler les flux de données sensibles avant qu’ils n’atteignent l’interface d’un modèle externe.
- Filtrer systématiquement les sorties générées pour détecter toute fuite involontaire d’informations confidentielles.
- Restreindre les droits d’accès aux journaux techniques aux seules personnes habilitées, pour éviter une exposition secondaire des données journalisées.
Sur ce dernier point, l’obligation devient explicite : les déployeurs de systèmes d’IA doivent conserver automatiquement les journaux générés par le système pendant au moins six mois, sauf disposition contraire prévue par un texte spécifique. Cette conservation constitue souvent la seule preuve tangible en cas d’audit ou de réclamation.
Conseil de pro : testez le filtrage de vos sorties avec des invites volontairement piégeuses avant la mise en production, plutôt que d’attendre qu’un utilisateur le découvre à votre place.
Feuille de route priorisée pour une mise en conformité rapide
Une mise en conformité efficace suit un ordre logique, où chaque étape produit une preuve exploitable pour la suivante.
- Cartographier tous les usages actuels de l’IA générative dans l’entreprise, y compris les usages informels non validés par la direction.
- Rédiger une charte d’usage opposable, précisant les données interdites de saisie et les outils autorisés.
- Lancer une AIPD ou une vérification du statut du modèle selon la méthodologie de la CNIL.
- Formaliser les contrats avec les fournisseurs, en exigeant leur documentation technique et leurs garanties de transfert.
- Tester techniquement les mesures de mitigation retenues et documenter les résultats.
Le DPO pilote naturellement l’AIPD et le registre des traitements, le RSSI valide les mesures de sécurité et l’intégration au système d’information, le juriste sécurise les contrats fournisseurs, et les équipes produit garantissent que les usages réels correspondent à la charte adoptée.
| Étape | Responsable | Preuve attendue |
|---|---|---|
| Cartographie des usages | Produit / IT | Registre des traitements à jour |
| Charte d’usage | DPO / juriste | Document signé et diffusé |
| AIPD ou vérification du modèle | DPO | Rapport daté avec tests documentés |
| Contrats fournisseurs | Juriste | Clauses de transfert et garanties techniques |
| Tests de sécurité | RSSI | Journal des tests et correctifs appliqués |
Documenter ses preuves : le rôle de la capture du savoir tacite
La conformité ne se prouve jamais sur une déclaration d’intention : elle se prouve par des documents datés, cohérents entre eux et facilement retrouvables. Une AIPD solide, des journaux conservés, des tests de mitigation reproductibles et des contrats à jour forment ensemble ce dossier de preuve.
- L’AIPD doit rester accessible et compréhensible plusieurs mois après sa rédaction, souvent par une personne qui n’était pas présente lors de sa création.
- Les chartes d’usage perdent leur valeur si elles ne sont pas rattachées à une trace de diffusion effective auprès des équipes.
- Les décisions techniques prises pour filtrer ou limiter les sorties d’un modèle méritent d’être expliquées, pas seulement listées.
C’est précisément ce point que la capture du savoir tacite adresse : quand un responsable conformité ou un chef de projet quitte l’entreprise, la logique derrière ses choix documentaires part souvent avec lui. Skillsay capture ce savoir par une IA vocale qui interroge directement les experts, Olivia, pour transformer leur raisonnement en connaissances structurées et réutilisables, utiles pour reconstituer ou justifier une AIPD, une charte ou une procédure de filtrage bien après leur rédaction initiale.
Données sensibles et catégories particulières dans l’entraînement
Le RGPD réserve un traitement renforcé aux données dites sensibles, telles que la santé, les opinions politiques, l’origine ethnique ou l’orientation sexuelle. Leur présence dans un corpus d’entraînement, même involontaire, active des obligations bien plus strictes que pour une donnée personnelle ordinaire.
Un modèle entraîné sur des données publiques peut malgré tout intégrer des informations sensibles glissées dans des textes libres, comme des témoignages ou des publications sur des réseaux sociaux. La détection de ces catégories particulières exige un filtrage en amont de l’entraînement, doublé d’une vérification a posteriori sur les sorties générées, car un modèle peut restituer une information sensible sans qu’elle ait été explicitement recherchée.
Pour les entreprises qui développent leurs propres modèles ou affinent des modèles existants sur des données internes, la vigilance porte aussi sur les fichiers RH, les dossiers médicaux du travail ou les données de santé collectées dans un contexte professionnel. Ces catégories imposent une base légale renforcée, souvent le consentement explicite ou une obligation légale précise, et rarement le simple intérêt légitime invoqué pour d’autres traitements. Documenter cette base légale avant l’entraînement évite une remise en cause complète du modèle après coup.

Qui porte la responsabilité en cas de violation de données par l’IA
Une violation de données provoquée par un système d’IA générative, qu’il s’agisse d’une fuite via les sorties du modèle ou d’un accès non autorisé aux journaux techniques, engage la responsabilité de l’entité qui contrôle le traitement au moment de l’incident. Le déployeur reste généralement responsable devant la CNIL pour les usages qu’il a mis en place, même lorsque la vulnérabilité technique provient du modèle fourni par un tiers.
Cette responsabilité ne s’efface pas automatiquement par un simple renvoi contractuel vers le fournisseur. Une entreprise qui n’a pas exigé de garanties techniques suffisantes, ou qui n’a pas conservé les journaux requis par le règlement sur l’IA, s’expose à une responsabilité aggravée en cas de contrôle, faute de preuve de diligence. Le fournisseur, de son côté, reste responsable des défauts intrinsèques à son modèle, notamment s’il n’a pas correctement documenté ou testé les risques de réidentification.
En pratique, la répartition des responsabilités se règle largement en amont, dans les clauses contractuelles négociées avec le fournisseur. Une entreprise qui n’a jamais formalisé ces clauses découvre souvent, au moment de l’incident, qu’elle porte seule l’essentiel du risque juridique.
Ce que montrent des cas concrets d’usage d’outils d’IA générative
Un service client qui utilise un assistant conversationnel pour répondre automatiquement aux demandes entrantes doit s’assurer que les échanges contenant des données personnelles de clients ne sont pas conservés au-delà de la finalité initiale, ni réutilisés pour entraîner davantage le modèle sans base légale distincte.
Une équipe RH qui s’appuie sur un générateur de texte pour rédiger des offres d’emploi ou des synthèses d’entretiens prend un risque différent : les notes d’entretien contiennent souvent des données personnelles détaillées sur les candidats, parfois sensibles, qui ne devraient jamais transiter vers un outil externe sans filtrage préalable.
Un service marketing qui génère des visuels ou des textes personnalisés à partir de données clients doit vérifier que ces données ne sont pas transmises en clair à un service hébergé hors Union européenne, sous peine d’activer les obligations de transfert international vues plus haut. Dans chacun de ces cas, la question centrale reste la même : quelles données entrent dans l’outil, sous quelle base légale, et que devient la trace de cet usage une fois le résultat produit.
Interopérabilité et portabilité des données produites par l’IA
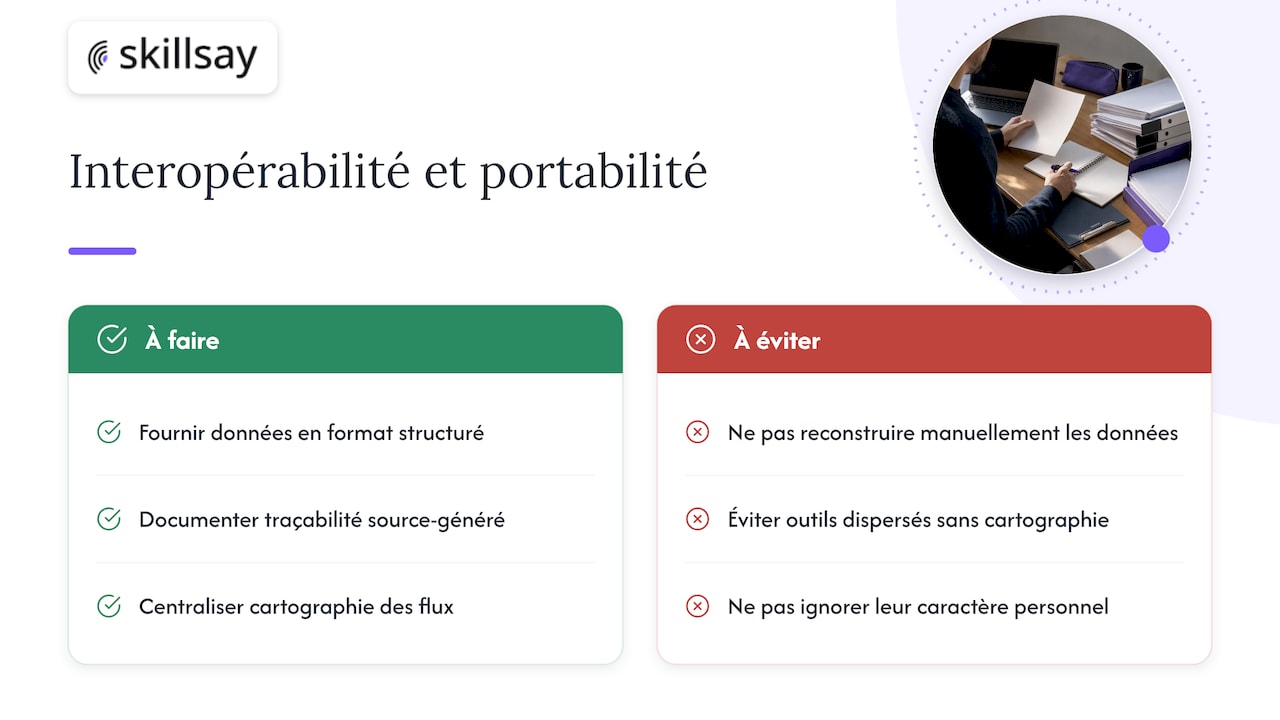
Le RGPD garantit à toute personne le droit de récupérer ses données personnelles dans un format structuré et réutilisable, un droit qui s’applique aussi aux contenus produits ou influencés par un système d’IA générative. Une entreprise qui génère des profils clients enrichis par IA doit pouvoir extraire ces données sous une forme exploitable si la personne concernée en fait la demande.
Cette exigence pose une difficulté technique propre à l’IA générative : les données générées ne correspondent pas toujours à une donnée brute clairement identifiable, mais à une synthèse ou une reformulation produite par le modèle. Documenter la traçabilité entre la donnée source et le contenu généré devient alors nécessaire pour honorer une demande de portabilité sans tout reconstruire manuellement.
L’interopérabilité entre systèmes pose un enjeu voisin : plus une entreprise multiplie les outils d’IA générative connectés à des bases de données internes différentes, plus elle complique sa capacité à répondre rapidement à une demande d’accès ou de suppression. Centraliser la cartographie des flux de données entre ces outils, plutôt que la laisser dispersée entre plusieurs équipes, reste la meilleure garantie de pouvoir répondre à ces demandes dans les délais imposés par le RGPD.
Regarder au-delà de 2026 : ce qui va probablement se durcir
L’arrivée de l’IA agentique change la nature du risque : quand un système décide et agit de façon autonome, la traçabilité classique par journaux ne suffit plus toujours à reconstituer une chaîne de décision. La CNIL a déjà noté ce changement d’échelle dans ses travaux récents.
Les contrôles vont probablement se resserrer sur les preuves techniques plutôt que sur les seules déclarations d’intention. Miser dès maintenant sur une gouvernance capable de s’adapter, appuyée par des preuves documentées en continu plutôt que reconstituées à la dernière minute, reste le pari le plus raisonnable pour une direction qui veut éviter les mauvaises surprises.
— quentin
Documenter sa conformité sans y passer des mois
La plupart des dirigeants qui se lancent dans une AIPD découvrent le même obstacle : la charte d’usage existe, le registre des traitements aussi, mais la logique qui a conduit à chaque décision reste dans la tête de la personne qui l’a prise. Quand cette personne change de poste ou quitte l’entreprise, ce raisonnement disparaît avec elle, et le dossier de preuve perd sa cohérence.
Skillsay propose une réponse ciblée à ce problème précis, sans se substituer à votre DPO ni à votre juriste. Olivia, notre IA vocale, interroge directement vos experts internes pour capturer ce qu’ils savent mais qui n’est écrit dans aucun document : méthodes de filtrage retenues, raisons d’un choix technique, justification d’une base légale.
- Interview vocale par IA pour l’offboarding, disponible moyennant un coût par profil en une seule fois.
- Structuration automatique des savoirs capturés en documents exploitables pour vos dossiers de conformité.
- Génération de livrables directement utilisables pour appuyer une AIPD ou une revue de gouvernance.
L’abonnement complet à la plateforme de Knowledge Management enrichie par l’IA est disponible sous forme d’abonnement mensuel par entité. Pour explorer comment Olivia capture ce savoir métier avant qu’il ne disparaisse, consultez la page interview IA d’Olivia.
Sources
Pour approfondir chaque obligation évoquée, quatre ressources publiques suffisent à couvrir l’essentiel du sujet.
- AI Act Service Desk — calendrier de mise en œuvre
- CNIL — Analyser le statut d’un modèle d’IA au regard du RGPD
- ANSSI — recommandations de sécurité pour un système d’IA générative
Questions fréquentes
Le RGPD s’applique-t-il vraiment à tous les outils d’IA générative ?
Le RGPD s’applique dès qu’un système d’IA générative traite des données personnelles, que ce soit à l’entraînement, à l’usage courant ou dans ses réponses générées. La CNIL propose une méthodologie précise pour vérifier au cas par cas si un modèle donné entre dans ce champ d’application.
Quelle réglementation encadre l’IA en France aujourd’hui ?
En France, l’IA générative est encadrée par le RGPD pour tout ce qui concerne les données personnelles, et par le règlement européen sur l’IA pour les obligations de transparence et de sécurité technique. Le calendrier de mise en œuvre fixe les prochaines échéances d’application jusqu’en 2027.
Que prévoit l’article 44 du RGPD pour l’IA générative ?
L’article 44 du RGPD encadre les transferts de données personnelles hors de l’Union européenne, ce qui concerne directement les entreprises qui utilisent des outils d’IA générative hébergés à l’étranger. Ces transferts restent possibles à condition d’être couverts par des clauses contractuelles types ou d’autres garanties appropriées.
Que dit l’article 50 du règlement sur l’IA sur la transparence ?
L’article 50 impose d’informer clairement les personnes lorsqu’elles interagissent avec un système d’IA ou consultent un contenu qu’il a généré. Les lignes directrices de la Commission européenne précisent que ce marquage doit rester lisible, y compris par des moyens techniques automatisés.
Quels outils permettent de vérifier la conformité RGPD d’une IA générative ?
Il n’existe pas d’outil unique de certification universelle, mais des méthodologies officielles, notamment celle de la CNIL pour analyser le statut d’un modèle, combinées à des tests d’attaques documentés et des audits de sécurité menés selon les recommandations de l’ANSSI.