Chatbot interne sur documents : l’architecture qui garantit des réponses fiables
Pour un chatbot interne fiable sur vos documents, privilégiez une architecture RAG plutôt qu’un fine-tuning, et traitez la qualité des données comme votre priorité absolue. La fiabilité des réponses dépend d’abord de la gouvernance documentaire et de la traçabilité des sources, bien avant le choix du modèle. Quand la documentation écrite ne suffit pas, l’interview IA permet de capturer le savoir tacite que vos experts n’ont jamais formalisé.
En bref:
- Le RAG actualise le corpus en quelques minutes sans réentraîner le modèle ; réservez le réentraînement aux jargons ou raisonnements métier stables.
- La fiabilité dépend davantage du corpus que du modèle : nettoyez les doublons, segmentez selon les sections et indiquez version, auteur et date de validation.
- Pour les corpus mêlant tableaux et notes, combinez recherche vectorielle et recherche par mots clés ; privilégiez un hébergement souverain si des données personnelles sont présentes.
- L’article 26 de l’AI Act exige la journalisation et la conservation des journaux pendant au moins six mois, ainsi que l’information des travailleurs concernés.
Table des matières
- Pourquoi préférer RAG à un fine-tuning pour un chatbot interne documentaire
- Collecte et préparation des documents pour assurer des réponses fiables
- Indexation et recherche : embeddings, bases vectorielles et stratégies de recherche
- Concevoir des prompts, templates de Q&A et mécanismes de sourcing des réponses
- Gouvernance, conformité et sécurité : RGPD, CNIL et obligations de l’AI Act
- Évaluer et maintenir la qualité des réponses : tests, métriques et workflows de mise à jour
- Comment Skillsay enrichit un chatbot documentaire grâce à la captation du savoir tacite
- Point de vue de l’auteur : les priorités opérationnelles qui comptent vraiment
- Skillsay : une solution pour alimenter un chatbot interne fiable sur tous vos savoirs
- Questions fréquentes
- Sources
Pourquoi préférer RAG à un fine-tuning pour un chatbot interne documentaire
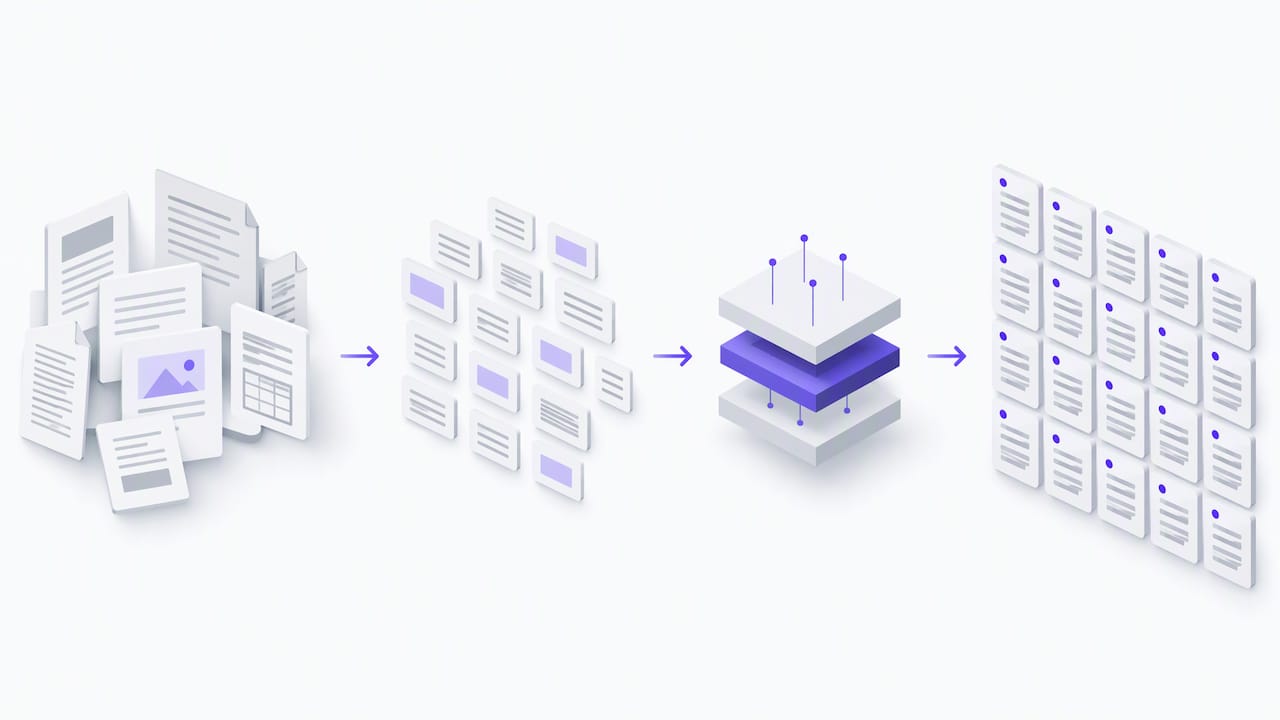
Le RAG, ou génération augmentée par récupération, connecte un modèle de langage à votre documentation sans réentraîner ce modèle. Concrètement, le système découpe vos documents en fragments, les transforme en vecteurs, puis récupère les passages les plus pertinents pour les injecter dans la réponse générée. Cette logique de recherche puis génération explique pourquoi le RAG s’est imposé comme l’architecture de référence pour la majorité des projets de chatbot documentaire en entreprise.
Le fine-tuning, qui consiste à réentraîner un modèle sur votre corpus, pose un problème structurel : chaque mise à jour de vos procédures impose un nouveau cycle d’entraînement, coûteux et lent. Le RAG, lui, reflète vos documents en temps réel.
- Mise à jour du corpus en quelques minutes, sans réentraînement du modèle.
- Traçabilité native : chaque réponse peut citer le document source.
- Coûts d’infrastructure et délais de déploiement nettement réduits.
Le fine-tuning reste justifié dans des cas précis : adapter le style de réponse à un jargon très spécifique, ou encoder un raisonnement métier stable qui ne change presque jamais. Pour la gestion documentaire courante, le RAG reste le choix le plus pragmatique.
Collecte et préparation des documents pour assurer des réponses fiables
Un chatbot documentaire n’est jamais meilleur que les documents qu’on lui donne à lire. Avant toute indexation, il faut cartographier vos sources et les nettoyer.
- Inventoriez vos sources prioritaires : procédures internes, tickets de support résolus, contrats types, comptes-rendus et transcriptions d’entretiens.
- Extrayez le texte brut, avec OCR pour les documents scannés, puis normalisez l’encodage et supprimez les doublons.
- Découpez chaque document en fragments cohérents, alignés sur les sections naturelles plutôt que sur un nombre fixe de caractères.
- Enrichissez chaque fragment de métadonnées : date de création, version, auteur, statut de validité.
- Mettez en place un filtre temporel qui écarte ou signale les contenus obsolètes avant qu’ils ne soient cités dans une réponse.
Conseil de pro : Taguez systématiquement vos documents avec une date de dernière validation : c’est le signal le plus simple pour éviter qu’un chatbot cite une procédure remplacée depuis des mois.
Cette étape de préparation conditionne directement la performance du système : la qualité du jeu de données source pèse davantage sur la fiabilité des réponses que le choix du modèle de langage lui-même. Nos équipes gagnent du temps en structurant ce travail dès le départ plutôt qu’en corrigeant des réponses erronées après coup, un travail que décrit bien ce guide sur l’analyse de documents par IA.
Indexation et recherche : embeddings, bases vectorielles et stratégies de recherche
Le choix du modèle d’embeddings doit correspondre à la langue et au vocabulaire de votre domaine : un modèle généraliste capte mal le jargon technique ou réglementaire propre à certains métiers. Les bases vectorielles comme Qdrant, Weaviate ou l’extension pgvector pour PostgreSQL se comparent sur trois critères concrets.
- La scalabilité face à un corpus qui grossit de plusieurs milliers de documents par an.
- La latence de recherche, déterminante pour une expérience fluide côté utilisateur.
- Les options d’hébergement disponibles, cloud public, cloud souverain ou on-premise.
Quand votre corpus mélange documents structurés (tableaux, formulaires) et contenus non structurés (notes libres, transcriptions), une recherche hybride combinant vectoriel et BM25 capture souvent mieux les requêtes précises, comme un numéro de référence ou un code produit, qu’une recherche purement sémantique. Enfin, le mode d’hébergement se décide selon la sensibilité des données traitées : la CNIL recommande de privilégier un hébergement souverain ou on-premise dès que des données personnelles entrent dans le corpus.
Concevoir des prompts, templates de Q&A et mécanismes de sourcing des réponses
Un bon prompt RAG injecte les fragments récupérés et exige explicitement une réponse sourcée, en précisant au modèle qu’il doit citer le document d’origine ou répondre qu’il ne sait pas plutôt que d’inventer.
- Un pattern de prompt type injecte les chunks les plus pertinents, limite la réponse à ces chunks et impose la citation du document source.
- Des templates de réponse adaptés à l’audience : un ton technique pour l’IT, synthétique pour les équipes opérationnelles, formel pour les sujets RH.
- Une stratégie de repli claire : en cas d’incertitude, le chatbot doit renvoyer vers un expert humain plutôt que de deviner.
Conseil de pro : Testez systématiquement votre chatbot avec des questions dont vous connaissez l’absence de réponse dans le corpus : un bon système doit dire « je ne sais pas » plutôt qu’inventer une réponse plausible.
Les procédures de test adversarial, questions pièges, formulations ambiguës, permettent de détecter ces hallucinations avant la mise en production plutôt qu’après.
Gouvernance, conformité et sécurité : RGPD, CNIL et obligations de l’AI Act
La gouvernance n’est pas une case à cocher après coup : elle structure l’ensemble du projet dès la conception. L’AI Act impose aux déployeurs de systèmes d’IA à risque des obligations précises de journalisation, de surveillance et de conservation des journaux pendant au moins six mois, ainsi qu’une information des travailleurs concernés par le déploiement.
- Journalisez chaque requête et chaque réponse pour assurer la traçabilité exigée par l’article 26 de l’AI Act.
- Cloisonnez la mémoire documentaire par service ou par niveau d’habilitation, avec des contrôles d’accès stricts.
- Informez les représentants du personnel avant tout déploiement touchant les pratiques de travail, conformément aux recommandations RGPD applicables.
- Vérifiez les clauses contractuelles avec vos sous-traitants d’hébergement, notamment les garanties de localisation et de suppression des données.
Ces obligations ne ralentissent pas le projet : elles en sécurisent l’adoption, en donnant aux équipes la confiance nécessaire pour utiliser l’outil au quotidien.
Évaluer et maintenir la qualité des réponses : tests, métriques et workflows de mise à jour
Un chatbot documentaire se pilote comme n’importe quel système critique, avec des métriques suivies dans le temps.
- Suivez la précision factuelle des réponses, le taux de réponses effectivement sourcées et le taux d’escalade vers un humain.
- Constituez un corpus de test représentatif et exécutez des tests de régression à chaque mise à jour du corpus documentaire.
- Structurez le projet en trois temps : POC sur un périmètre restreint, pilote avec un groupe d’utilisateurs, puis production, en impliquant dès le départ les équipes Knowledge, IT et métier.
- Mettez en place une boucle de feedback où les utilisateurs signalent les réponses incorrectes, alimentant une révision éditoriale continue du corpus.
Cette discipline de test rejoint les priorités identifiées dans notre article sur les POC RAG en entreprise, où la préparation du périmètre de test conditionne souvent la réussite du passage en production.
Comment Skillsay enrichit un chatbot documentaire grâce à la captation du savoir tacite
La documentation écrite ne capture jamais tout ce que savent vos experts. Beaucoup de raisonnements, d’astuces et de pratiques métier ne sont écrits nulle part, ils vivent uniquement dans la tête des personnes qui les appliquent au quotidien. C’est ce que nous captons avec Olivia, notre IA vocale qui interviewe vos experts : elle pose les questions qui font émerger ce savoir tacite, puis le structure automatiquement en connaissances exploitables.
Ce contenu structuré s’intègre ensuite directement dans la même base vectorielle que vos documents classiques, interrogeable par notre solution de chat documentaire. Les cas d’usage les plus fréquents concernent l’offboarding d’un expert qui part à la retraite, les procédures critiques jamais rédigées, ou le transfert de compétences entre deux générations de collaborateurs, des situations détaillées dans notre étude sur l’interview vocale IA.
Point de vue de l’auteur : les priorités opérationnelles qui comptent vraiment
Avant de lancer un chatbot documentaire, cartographiez les savoirs critiques, ceux qui partiraient avec un départ. Lancez un POC ciblé sur ce périmètre plutôt qu’un déploiement général : vous apprendrez plus vite ce qui fonctionne. Impliquez les managers tôt, l’adhésion des experts fait ou défait un projet de capture du savoir. Mesurez le ROI par deux chiffres simples : le temps de recherche gagné et le taux de bonnes réponses dès la première tentative.
— quentin
Skillsay : une solution pour alimenter un chatbot interne fiable sur tous vos savoirs
Un chatbot bien architecturé ne vaut que ce que vaut son corpus. Là où les outils classiques s’arrêtent à vos documents existants, nous allons chercher ce qui n’est écrit nulle part : les méthodes, les astuces et les raisonnements que vos experts appliquent sans jamais les formaliser. Olivia mène ces entretiens vocaux, structure automatiquement les réponses, et alimente la même base interrogeable que vos documents, vidéos et comptes-rendus.
- Olivia interview vos experts par la voix et capture leur savoir tacite sans effort de rédaction de leur part.
- Notre plateforme intègre documents, audios et vidéos dans une mémoire d’entreprise unique, interrogeable par des agents IA multilingues.
- Nous proposons un POC ciblé sur un périmètre métier critique avant tout déploiement à grande échelle.
| Offre | Ce qu’elle couvre | Tarif |
|---|---|---|
| Interview vocale IA, offboarding | Capture du savoir tacite d’un expert sortant | le prix publié par l’éditeur pour un profil ponctuel |
| Plateforme Knowledge Management augmentée par l’IA | Intégration documentaire, base interrogeable, agents IA | 999 € par mois et par entité |
Pour sécuriser un départ à venir ou enrichir votre future base documentaire, contactez-nous pour discuter d’un POC sur votre solution de chat documentaire.
Questions fréquentes
Quels sont les meilleurs outils conversationnels d’IA ?
Les meilleurs outils dépendent de l’usage : un chatbot basé sur une architecture RAG convient à la plupart des besoins documentaires internes, tandis que des plateformes spécialisées existent pour l’automatisation de workflows ou l’intégration multicanal, comme le détaille cet article sur le fonctionnement des assistants virtuels en entreprise. Le choix dépend surtout de la qualité de vos données sources et de vos exigences de gouvernance.
Quel est le prix d’un chatbot IA ?
Pour une solution de Knowledge Management augmentée par l’IA incluant base interrogeable et agents IA, notre tarif est de 999 € par mois et par entité.
Comment traduit-on « chatbot » en français ?
Le terme français recommandé est « agent conversationnel » ou « robot conversationnel », bien que « chatbot » reste largement utilisé dans le langage professionnel courant. Les deux formulations désignent le même type de système.
Quel est le rôle d’un chatbot documentaire en entreprise ?
Un chatbot documentaire répond aux questions des collaborateurs en s’appuyant sur les documents internes de l’organisation, procédures, contrats, tickets résolus, plutôt que sur des connaissances générales. Son rôle principal est de réduire le temps de recherche d’information et de fiabiliser les réponses grâce à des sources citées.
Comment garantir que les réponses du chatbot restent pertinentes et à jour ?
La pertinence dépend d’un filtrage temporel qui écarte les contenus obsolètes et d’une boucle de feedback continue où les utilisateurs signalent les réponses incorrectes. Une gouvernance éditoriale régulière du corpus documentaire reste la garantie la plus fiable.