Ontologie métier : la modéliser pour la rendre exploitable par l'IA

Ontologie métier : la modéliser pour la rendre exploitable par l’IA
Une ontologie métier est un modèle formel de vos concepts et de leurs relations qui permet aux systèmes et aux agents IA de raisonner avec le vocabulaire réel de votre entreprise. Sa promesse est directe : transformer un savoir dispersé en une structure interrogeable, capable d’alimenter la recherche, la gouvernance et les agents conversationnels. Les sections suivantes détaillent ses composants, la méthode de construction et son intégration technique.
En bref:
- La construction d’une ontologie métier doit se concentrer d’abord sur un domaine à forte valeur, en impliquant directement les experts pour capturer leur savoir tacite rapidement.
- Peupler une ontologie semi-automatiquement repose sur la collecte de sources, l’extraction terminologique, la proposition de schéma et la validation humaine pour assurer la fiabilité des concepts.
- Connectée à des systèmes IA, une ontologie fournit un contexte structuré essentiel pour éviter de générer des réponses incohérentes ou obsolètes dans les agents conversationnels ou la recherche d’entreprise.
- La gouvernance continue est indispensable pour maintenir la qualité d’une ontologie, en impliquant des experts métier, un responsable de la gouvernance, et une équipe technique pour la mise à jour et la validation.
- Utiliser des outils comme Olivia permet de capturer efficacement le savoir tacite des experts, surtout avant leur départ, en complément des méthodes d’extraction de textes ou de bases de connaissances extérieures.
Table des matières
- Qu’est-ce qu’une ontologie métier, concrètement ?
- Pourquoi construire une ontologie métier change la donne opérationnelle
- Comment structurer les concepts et les relations d’une ontologie ?
- Comment construire et peupler une ontologie métier sans y passer des mois ?
- Comment une ontologie alimente-t-elle des agents IA fiables ?
- Comment garantir la qualité d’une ontologie dans la durée ?
- Comment capturer le savoir tacite pour peupler une ontologie métier ?
- Notre avis : priorisez le tacite avant de peaufiner le schéma
- Skillsay pour transformer vos experts en ontologie exploitable
- Sources
- Questions fréquentes
Qu’est-ce qu’une ontologie métier, concrètement ?
Une ontologie métier repose sur quatre briques : des classes (les concepts métier, comme « client », « contrat », « incident »), des relations typées entre ces classes, des axiomes qui posent des règles logiques, et des instances qui peuplent le modèle avec des données réelles. Cette architecture la distingue nettement d’un glossaire ou d’une taxonomie.
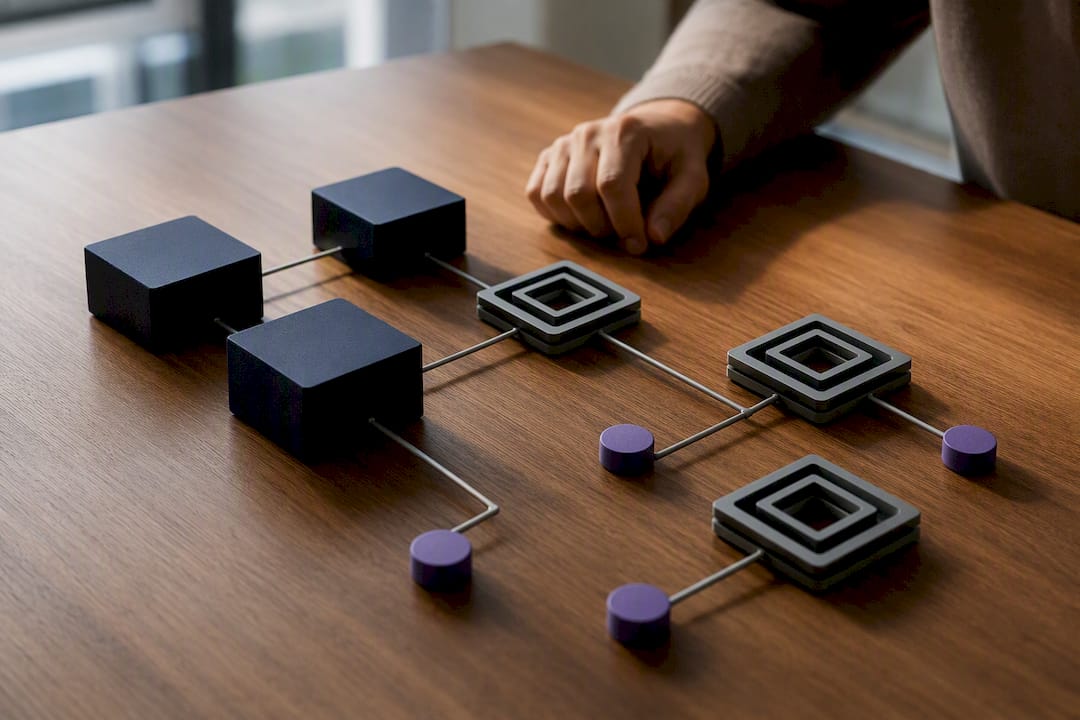
Un glossaire liste des définitions sans relation entre elles. Une taxonomie hiérarchise des catégories, mais reste linéaire, une simple arborescence de « est un » sans logique transversale. L’ontologie, elle, encode des relations multiples et croisées, ce qui permet d’exprimer des déductions. La page de référence sur Wikipédia) résume bien cette distinction : l’ontologie formalise un domaine de connaissances avec suffisamment de rigueur pour qu’une machine puisse en tirer des inférences, pas seulement l’afficher.
Cette rigueur s’appuie sur des standards éprouvés :
- OWL (Web Ontology Language) structure les classes, propriétés et axiomes logiques dans un formalisme interprétable par des moteurs d’inférence.
- RDF (Resource Description Framework) encode les faits sous forme de triplets sujet-prédicat-objet, la brique de base du web sémantique.
- SPARQL interroge ces graphes de connaissances avec une syntaxe proche du SQL, mais pensée pour naviguer entre entités liées plutôt qu’entre tables.
Une ontologie de domaine bien conçue doit rester dynamique et sémantiquement liée : elle exprime des déductions utiles à l’entreprise, comme le fait qu’une filiale hérite d’un droit d’usage via une relation de propriété, sans que personne n’ait eu à écrire cette règle explicitement quelque part. C’est précisément ce que rappelle ProMethee-TI : l’intérêt de l’ontologie sémantique tient à sa capacité d’inférence, pas à sa fonction de simple répertoire.
Pourquoi construire une ontologie métier change la donne opérationnelle
Les entreprises qui investissent dans une architecture d’ontologie le font rarement par goût théorique. Elles cherchent des gains mesurables sur des cas d’usage précis.
Les applications les plus fréquentes touchent quatre terrains :
- Agents IA et assistants conversationnels : l’ontologie fournit le vocabulaire de référence qui évite les réponses génériques ou hors contexte.
- Recherche d’entreprise : au lieu de mots-clés, le moteur navigue par concepts et relations, ce qui améliore la pertinence sur des requêtes complexes.
- Gouvernance des données : l’ontologie sert de référentiel unique pour aligner les définitions entre départements qui, sinon, parlent chacun leur propre dialecte métier.
- Référentiels compétences RH : structurer les compétences, leurs équivalences et leurs prérequis facilite la mobilité interne et la détection des écarts de compétences.
Les bénéfices se mesurent sur des indicateurs concrets : temps de recherche d’information, taux de réutilisation des connaissances, cohérence terminologique entre équipes, et fiabilité des réponses générées par les agents IA. Une entreprise qui structure ses définitions métier réduit aussi les frictions lors des audits de conformité, car les règles ne dépendent plus de la mémoire d’une seule personne.
Mais le chantier n’est pas sans obstacles. Trois défis reviennent systématiquement : l’alignement entre équipes sur des définitions parfois contradictoires, la maintenance dans le temps quand l’organisation évolue plus vite que le modèle, et l’adoption réelle par les équipes métier qui doivent alimenter et valider la structure plutôt que la subir.
Conseil de pro : Ne lancez jamais une ontologie métier sur l’ensemble de l’entreprise en une fois. Choisissez un domaine à forte valeur, comme le service client ou la conformité réglementaire, démontrez le gain en quelques semaines, puis étendez.
Comment structurer les concepts et les relations d’une ontologie ?
Modéliser une ontologie métier suit une logique qu’on peut résumer en quatre étapes de raisonnement.
- Identifier les classes. Ce sont les concepts noyaux du domaine : « produit », « fournisseur », « anomalie qualité ». Chaque classe doit correspondre à une réalité métier stable, pas à un attribut ou une valeur ponctuelle.
- Définir les propriétés et les relations typées. Une relation comme « produit_fabriqué_par fournisseur » porte un sens précis, différent d’une simple association. Typer ces relations (obligatoire, unique, transitive) conditionne la qualité des inférences futures.
- Poser des axiomes. Un axiome encode une règle logique : « si un contrat est résilié, alors les accès associés doivent être révoqués ». C’est cette couche qui transforme un schéma statique en système capable de raisonner. Un moteur d’inférence peut alors déduire automatiquement des faits qui ne sont écrits nulle part explicitement.
- Peupler avec des instances. Les instances sont les données réelles : ce client précis, ce contrat précis, cette anomalie précise, rattachés aux classes et relations définies plus haut.
La gestion des variantes linguistiques mérite une attention particulière dès cette phase de structuration. Un même concept métier se cache souvent derrière des abréviations, des fautes de frappe récurrentes ou du jargon propre à un service, et les travaux sur les modèles de langage chez IBM rappellent que cette synonymie doit être traitée en amont, pas corrigée après coup.
Comment construire et peupler une ontologie métier sans y passer des mois ?
Le principal frein à l’adoption des ontologies métier n’est pas conceptuel, il est opérationnel : peupler un modèle à la main, concept par concept, ne passe pas à l’échelle. La bonne nouvelle, c’est que la construction n’a plus besoin d’être entièrement manuelle depuis que des méthodes semi-automatiques existent.
La feuille de route la plus robuste suit six étapes :
- Collecte des sources : documents métier, procédures, référentiels existants, comptes-rendus.
- Extraction terminologique : repérage des entités et relations candidates via des techniques de reconnaissance d’entités nommées (NER) et d’extraction de relations (RE).
- Proposition de schéma : première ébauche de classes et relations, souvent assistée par des modèles de langage guidés par des prompts spécifiques au domaine.
- Peuplement : ajout des instances à partir des sources collectées, avec regroupement lexical des synonymes.
- Validation par des experts métier : relecture humaine systématique des propositions automatiques.
- Export et intégration : publication au format OWL ou RDF pour une utilisation par les systèmes en aval.
Cette logique itérative n’est pas une option de confort. Le cycle de vie d’une ontologie décrit par l’INRAE insiste sur ce point : une construction alignée sur des cas d’usage concrets fonctionne mieux qu’un mégaprojet monolithique pensé pour tout couvrir dès le départ.
Plusieurs outils et approches allègent concrètement le travail humain :
| Méthode ou outil | Fonction principale | Limite à connaître |
|---|---|---|
| CuriosiText | Peuplement semi-automatique via Word2Vec, regroupement de termes similaires depuis des textes mal normalisés | Nécessite une validation humaine sur les regroupements proposés |
| OntoConnectLM | Génération et enrichissement d’ontologies assistés par un LLM, avec liaison à des ressources externes | Requiert un encadrement méthodologique et un enrichissement externe pour rester fiable |
| Extraction depuis UML | Conversion de modèles de conception existants en squelette ontologique | Capture la structure mais rarement les règles métier implicites |
| Wikidata et DBpedia | Enrichissement des concepts par liaison à des bases de connaissances ouvertes | Utile pour l’interopérabilité, pas pour le vocabulaire propriétaire de l’entreprise |
CuriosiText illustre bien cette approche : l’application s’appuie sur Word2Vec pour repérer des termes proches sémantiquement dans des corpus de textes bruts, ce qui accélère nettement le regroupement lexical par rapport à une revue manuelle. De son côté, OntoConnectLM montre que les grands modèles de langage peuvent générer des propositions de structure ontologique, à condition d’être guidés par des prompts précis et enrichis via des ressources comme Wikidata ou DBpedia pour garantir l’interopérabilité.
Une étude de cas industrielle sur la construction semi-automatique d’ontologies à partir de textes français non structurés confirme une limite structurelle : certaines étapes, en particulier la découverte d’axiomes métier et de règles implicites, résistent à l’automatisation. La boucle humaine reste indispensable, non par prudence excessive, mais parce que l’expert métier détient souvent la seule version fiable d’une règle qui n’a jamais été écrite nulle part.
Comment une ontologie alimente-t-elle des agents IA fiables ?
Une ontologie métier ne prend toute sa valeur que lorsqu’elle est branchée à des systèmes actifs, pas quand elle dort dans un fichier statique. Son rôle dans les architectures d’intelligence artificielle générative repose sur trois fonctions précises.
Dans un dispositif de génération augmentée par récupération (RAG), l’ontologie fournit le contexte structuré qui évite aux modèles de langage de répondre de façon plausible mais fausse. Elle agit comme un filtre d’autorité : elle indique quelle source fait foi, quelle définition prévaut en cas de doublon, et quelles règles métier s’appliquent avant de générer une réponse. Algos AI le formule clairement : les modèles génératifs pris seuls dérivent facilement dès qu’on sort de leur zone d’entraînement, et l’ontologie d’entreprise fournit précisément le garde-fou sémantique qui leur manque.
Sur le plan technique, cette opérationnalisation s’appuie généralement sur une base graphe couplée à des couches sémantiques qui relient définitions métier, indicateurs et sources de données gouvernées. Databricks décrit cette approche autour de la notion de Metric Views et de pages sémantiques : chaque concept métier pointe vers une source de vérité unique, ce qui évite qu’un agent IA invente une définition ou pioche dans une donnée obsolète.
Trois contrôles sont indispensables à cette étape :
- Un contrôle d’accès qui limite la visibilité de certains concepts sensibles selon le rôle de l’utilisateur ou de l’agent.
- Un mécanisme de pertinence qui priorise les définitions les plus récentes en cas de conflit entre versions.
- Une validation à la source qui empêche un agent IA de générer une réponse sur un concept non encore validé par un expert métier.
Une approche pragmatique et centrée sur un domaine à forte valeur reste la voie la plus réaliste : elle limite le périmètre initial et permet de démontrer un résultat concret avant d’étendre l’ontologie à d’autres départements, une logique que confirme le retour d’expérience de Databricks sur ses déploiements clients.
Comment garantir la qualité d’une ontologie dans la durée ?
Une ontologie métier qui n’est jamais révisée devient rapidement un cimetière documentaire : des concepts qui ne correspondent plus à la réalité de l’entreprise, des relations obsolètes, une confiance qui s’érode. La gouvernance n’est donc pas une étape finale, c’est un processus continu.
La validation s’organise généralement autour de questions de compétence : des requêtes types que l’ontologie doit pouvoir résoudre correctement (« quels contrats sont liés à ce fournisseur et sous quelle clause ? »). Si le modèle échoue sur ces questions, il retourne en révision avant toute mise en production. Cette revue implique systématiquement des experts métier, pas seulement des data engineers, car eux seuls savent si une relation reflète vraiment la réalité opérationnelle.
Le suivi qualité s’appuie sur plusieurs indicateurs concrets :
- Cohérence logique : absence de contradictions entre axiomes.
- Couverture : proportion des concepts métier réels effectivement représentés dans le modèle.
- Taux d’acceptation : part des propositions générées automatiquement validées sans modification par les experts.
- Traçabilité des versions : historique des changements, avec justification de chaque modification structurelle.
Sur le plan organisationnel, trois rôles reviennent dans la plupart des dispositifs qui fonctionnent : un responsable de la gouvernance de l’ontologie qui arbitre les conflits de définition, des experts métier référents par domaine qui valident les propositions, et une équipe technique qui maintient le format d’export (OWL, RDF) et l’intégration aux systèmes en aval. Sans ce trio, l’ontologie dérive silencieusement, un concept à la fois.
Comment capturer le savoir tacite pour peupler une ontologie métier ?
Les sources écrites (documents, procédures, comptes-rendus) ne racontent jamais toute l’histoire. Les exceptions qu’un contrôleur qualité applique de mémoire, les heuristiques qu’un commercial senior utilise pour qualifier un prospect, le raisonnement qu’un ingénieur suit pour diagnostiquer une panne rare : ce savoir tacite existe, mais il n’apparaît dans aucun document, et il disparaît au moment du départ de la personne qui le détient.
C’est précisément la limite que les pipelines d’extraction automatique ne résolvent jamais complètement. Ils exploitent des textes existants, mais un texte ne contient que ce qui a été écrit, jamais ce qui reste dans la tête d’un expert. Combler ce vide exige une méthode différente : l’interview structurée.
C’est le rôle d’Olivia, l’IA vocale de Skillsay conçue pour interviewer vos experts et faire remonter ce qu’ils savent sans jamais l’avoir formalisé, méthodes, astuces de terrain, raisonnement face aux cas limites. Le principe suit une logique en trois temps :
- Interview structurée : Olivia pose les questions clés propres au domaine métier de l’expert, pas un questionnaire générique.
- Extraction conceptuelle : les réponses sont converties en concepts, relations et règles exploitables, le matériau brut d’une ontologie.
- Validation métier : chaque élément extrait passe par une revue humaine avant intégration, exactement comme pour un peuplement issu de sources documentaires.
Conseil de pro : Interrogez vos experts avant leur dernier trimestre, pas après leur départ. Une fois la personne partie, il ne reste que ce que d’autres se souviennent qu’elle savait, et c’est presque toujours incomplet.
Cette approche complète les méthodes de capture du savoir tacite en entreprise : elle ne remplace pas l’extraction depuis les documents existants, elle comble le vide que ces documents laissent toujours ouvert.
Notre avis : priorisez le tacite avant de peaufiner le schéma
La plupart des projets d’ontologie métier échouent pour la même raison : on passe des mois à raffiner un schéma théoriquement élégant, pendant que le savoir qui aurait vraiment fait la différence, celui dans la tête des experts terrain, continue à s’évaporer au fil des départs. C’est l’ordre des priorités qu’il faut inverser.
Une checklist réaliste pour un pilote en 60 à 90 jours tient en quatre points : choisissez un domaine unique à forte valeur, interviewez systématiquement les deux ou trois experts qui détiennent le plus de savoir non documenté sur ce domaine, construisez le schéma ontologique autour de ce qu’ils révèlent plutôt que l’inverse, puis validez avec des questions de compétence concrètes avant toute extension.
Mesurez l’impact sur un seul indicateur au départ : le temps que met une nouvelle recrue pour retrouver, seule, une réponse qu’elle aurait dû demander à un senior. Si ce temps chute, l’ontologie fonctionne. Le reste, cohérence logique, couverture, taux d’acceptation, vient affiner la mesure une fois la valeur démontrée.
— quentin
Skillsay pour transformer vos experts en ontologie exploitable
Skillsay est l’option pour capturer le savoir qu’aucun document n’a jamais retenu, celui que vos experts appliquent sans y penser et que les pipelines d’extraction textuelle ne verront jamais. Olivia mène l’interview vocale, pose les questions qui font émerger méthodes, exceptions et raisonnements de terrain, puis structure ces réponses en connaissances directement exploitables.
Trois cas d’usage concentrent l’essentiel de la valeur : sécuriser un départ ou une retraite avant que le savoir ne parte avec la personne, accélérer l’intégration de nouvelles recrues en leur donnant accès au raisonnement des seniors plutôt qu’à des procédures figées, et générer automatiquement des livrables métier à partir des connaissances capturées. Au-delà de l’interview, Skillsay enrichit cette base avec vos documents, audios et vidéos existants pour construire une mémoire d’entreprise interrogeable, capable d’alimenter des agents IA métier au quotidien.
Pour un départ ponctuel à sécuriser, l’interview vocale par IA en offboarding est proposée à un tarif unique par profil. Pour un déploiement continu à l’échelle de l’entreprise, la solution logicielle de gestion des connaissances enrichie par l’IA est facturée selon un abonnement mensuel. Découvrez le fonctionnement complet d’Olivia et demandez une démonstration pour évaluer ce que vos experts ont à révéler.
Sources
Pour approfondir la construction et le peuplement d’ontologies métier, plusieurs références techniques citées dans cet article méritent une lecture directe : le cycle de vie d’une ontologie selon l’INRAE pour la méthodologie itérative, CuriosiText et OntoConnectLM pour les approches semi-automatiques de peuplement, ainsi que le guide Databricks sur l’opérationnalisation des ontologies pour l’intégration aux architectures IA modernes.
- Cycle de vie d’une ontologie — INRAE / Vocabulaires ouverts
- CuriosiText: a web application based on Word2Vec helping with the population of ontologies — ACL Anthology (2018)
- OntoConnectLM — HAL
Questions fréquentes
Qu’est-ce qu’une ontologie exactement ?
Une ontologie est un modèle formel qui organise les concepts d’un domaine et les relations logiques entre eux, de façon à ce qu’un système puisse en tirer des déductions, pas seulement les afficher. Dans un contexte métier, elle sert de référentiel commun entre les équipes et les systèmes IA.
Quel est le synonyme d’ontologie en contexte informatique ?
Il n’existe pas de synonyme strict, mais les termes proches incluent « modèle de connaissances » ou « graphe de connaissances » selon le degré de formalisme visé. Une ontologie se distingue toutefois d’une simple taxonomie ou d’un glossaire par sa capacité d’inférence logique.
Que signifie le terme « ontologiste » ?
Un ontologiste est un professionnel spécialisé dans la conception et la maintenance de modèles ontologiques, souvent à la croisée de la linguistique computationnelle, de l’ingénierie des connaissances et du domaine métier concerné. Ce rôle recoupe fréquemment celui d’un architecte de la connaissance dans les grandes organisations.
Qu’est-ce qu’une ontologie en informatique, concrètement ?
En informatique, une ontologie encode des classes, des relations typées, des axiomes et des instances dans des formats standardisés comme OWL ou RDF, interrogeables via SPARQL. La définition encyclopédique de référence précise que cette structuration vise à rendre le sens explicite et exploitable par des machines, pas uniquement par des humains.
Comment démarrer une ontologie métier quand le savoir n’est pas documenté ?
Quand le savoir critique n’existe dans aucun document, l’interview structurée des experts métier reste la méthode la plus directe pour le faire émerger. Des outils comme Olivia, l’IA vocale de Skillsay, sont conçus spécifiquement pour cette étape, en posant les questions qui révèlent méthodes et raisonnements non écrits avant de les structurer en concepts exploitables.
Recommandations