Taxonomie documentaire : définition, méthode et normes à connaître
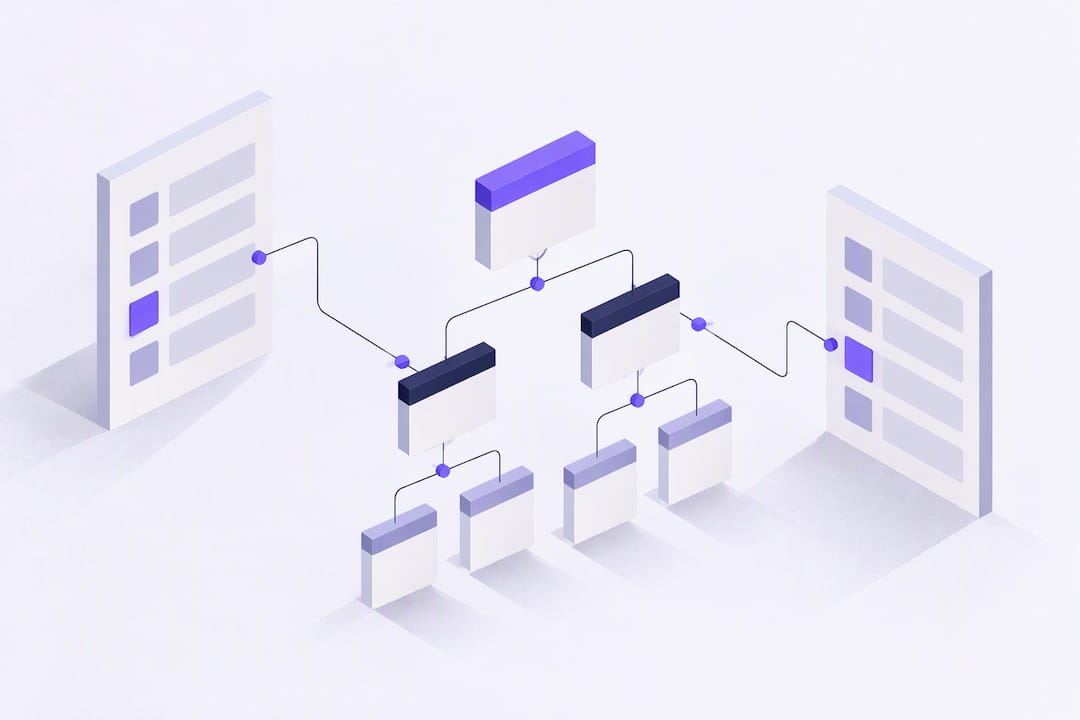
Une taxonomie documentaire est un vocabulaire contrôlé organisé en hiérarchie qui facilite le classement et la recherche des documents, en reliant chaque concept à ses parents et à ses enfants selon une logique du général au particulier. Elle sert à organiser, retrouver et réutiliser l’information dans un fonds documentaire, qu’il s’agisse de procédures internes ou de bases scientifiques. D’autres approches, comme le thésaurus ou la classification facettée répondent à des besoins voisins mais plus riches ou plus souples.
En bref:
- Une taxonomie documentaire se structure par relations hiérarchiques entre concepts, facilitant leur navigation du général vers le particulier.
- Le choix entre taxonomie, thésaurus et classification facettée dépend de la stabilité du domaine, de la richesse sémantique souhaitée ou de la transversalité du fonds.
- La conformité aux normes comme SKOS et ISO 25964 garantit l’interopérabilité et la réutilisation des vocabulaires contrôlés entre plusieurs systèmes.
- La conception efficace d’une taxonomie passe par un audit du corpus, la consultation d’experts et des tests auprès d’utilisateurs réels, avant la mise en œuvre.
- La captation du vocabulaire via des entretiens avec les praticiens enrichit la taxonomie en intégrant des termes non présents dans les documents écrits.
Table des matières
- Taxonomie documentaire : définition, structure et vocabulaire contrôlé
- Taxonomie vs thésaurus vs classification facettée : choisir la bonne approche
- Normes et interopérabilité : SKOS, ISO 25964 et vocabulaires européens
- Étapes pratiques pour concevoir et valider une taxonomie documentaire
- Mise en œuvre opérationnelle : indexation, gouvernance et mesures de suivi
- Pourquoi capturer le savoir tacite accélère la construction d’une taxonomie
- Ce que l’on sous-estime dans la construction d’une taxonomie
- Capturer les termes et relations qui manquent à votre taxonomie
- Questions fréquentes
- Sources
Taxonomie documentaire : définition, structure et vocabulaire contrôlé
Une taxonomie structure les concepts par relations génériques et spécifiques : un terme parent englobe plusieurs termes enfants, eux-mêmes susceptibles de se subdiviser encore. Cette architecture en arbre permet de naviguer du général vers le particulier sans ambiguïté, ce que confirme la définition retenue par EU Vocabularies, qui décrit la taxonomie comme un ensemble de relations parent-enfant entre concepts.
Chaque concept porte idéalement un identifiant pérenne et un libellé préférentiel unique, ce qui évite les doublons et les ambiguïtés de nommage quand plusieurs équipes alimentent le même référentiel. Cette rigueur paie concrètement dans trois usages courants :
- L’indexation des documents, qui devient plus rapide quand chaque fichier se rattache à un nœud précis de l’arbre.
- La navigation dans un intranet ou une base de connaissances, où l’utilisateur descend par paliers jusqu’au document recherché, bénéficie de bonnes pratiques présentées sur le Blog – Service HLP.
- La réutilisation du vocabulaire par plusieurs applications, du moteur de recherche interne aux outils d’analyse.
Une taxonomie bien construite n’est jamais figée : elle évolue avec le métier, mais chaque ajout respecte la même logique hiérarchique pour rester lisible.
Taxonomie vs thésaurus vs classification facettée : choisir la bonne approche
Trois familles de vocabulaires contrôlés répondent à des besoins différents, et les confondre coûte cher en maintenance.
- Le thésaurus ajoute aux relations hiérarchiques des relations d’équivalence (synonymes) et des relations associatives entre concepts proches sans lien de subordination. La norme ISO 25964 encadre sa construction et sa maintenance, ce qui en fait le choix naturel quand la richesse sémantique prime sur la simplicité.
- La taxonomie se limite à une hiérarchie unique et contrôlée, sans les relations associatives du thésaurus. Elle reste plus simple à piloter au quotidien, ce qui convient aux équipes qui veulent un classement stable plutôt qu’un réseau sémantique complexe.
- La classification facettée organise l’information selon plusieurs dimensions indépendantes (type de document, métier, date, statut) combinables à volonté. Selon Cursus, cette souplesse en fait l’approche recommandée pour les corpus interdisciplinaires, et l’intelligence artificielle facilite désormais l’analyse des relations à grande échelle pour la construire.
Le choix dépend donc moins d’une préférence que de la nature du corpus : un référentiel métier stable penche vers la taxonomie, un domaine scientifique vers le thésaurus, un fonds transversal vers les facettes.
Normes et interopérabilité : SKOS, ISO 25964 et vocabulaires européens
Publier une taxonomie que d’autres systèmes peuvent comprendre et réutiliser suppose de suivre des normes partagées plutôt que des formats maison.
SKOS (Simple Knowledge Organization System), porté par le W3C, offre un modèle standard pour représenter des vocabulaires contrôlés sur le web sémantique. Les vocabulaires contrôlés d’EU Vocabularies s’appuient sur ce modèle pour favoriser la réutilisation et l’alignement multilingue des concepts entre institutions.
ISO 25964 reste la référence pour les thésaurus et leur interopérabilité, en précisant les règles de structure, d’export et d’import des relations entre termes.
- SKOS facilite le partage d’un même concept entre plusieurs systèmes documentaires sans perte de sens.
- ISO 25964 garantit qu’un thésaurus construit dans un outil reste exploitable dans un autre.
- EuroVoc, référencé parmi les vocabulaires EU Vocabularies, illustre à grande échelle les bénéfices de l’alignement terminologique entre langues et institutions.
Le thésaurus INRAE comporte plusieurs milliers de concepts organisés en microthésaurus et conformes aux normes ISO et SKOS, ce qui en fait un exemple concret de référentiel institutionnel pensé pour l’interopérabilité scientifique.
Étapes pratiques pour concevoir et valider une taxonomie documentaire
Construire une taxonomie utile suit une progression assez constante, qu’il s’agisse d’un fonds de dix mille documents ou d’un référentiel métier naissant.
- Auditer le corpus existant : inventorier les documents, analyser les logs de recherche interne et recueillir les termes que les équipes emploient réellement, y compris ceux qui n’apparaissent dans aucun document écrit.
- Choisir le modèle de structuration : trancher entre mono-hiérarchie simple et classification facettée selon la diversité du corpus, en évitant de mélanger les deux logiques dans un même référentiel.
- Rédiger un guide éditorial : fixer les règles de nommage, la casse, le singulier ou le pluriel des libellés, et la profondeur maximale de l’arbre pour éviter une hiérarchie qui s’enfonce sans fin.
- Tester auprès des utilisateurs réels : faire indexer un échantillon de documents par des collaborateurs non impliqués dans la conception, puis mesurer le taux de non-correspondance entre leurs choix et la structure prévue.
- Itérer avant la mise en production : ajuster les termes ambigus ou redondants repérés lors des tests, puis figer une première version exploitable.
Conseil de pro : prévoyez des listes ouvertes pour les noms propres et les identifiants externes, car une taxonomie trop fermée vieillit mal face aux nouveaux clients, produits ou projets.
Cette logique de modèle de données, détaillée dans les travaux sur la conception d’un thésaurus pour le SNTP, s’applique tout autant aux taxonomies facettées, où chaque facette mérite son propre schéma de gestion.
Mise en œuvre opérationnelle : indexation, gouvernance et mesures de suivi
Une fois la structure validée, trois chantiers déterminent si la taxonomie vit ou s’enlise.
L’indexation peut rester manuelle pour de petits fonds, s’appuyer sur une assistance semi-automatique pour les volumes moyens, ou passer par une classification automatique pilotée par IA pour les corpus volumineux et hétérogènes. Chaque document indexé porte des métadonnées structurées, stockées dans un format qui reste interrogeable par les outils de recherche interne.
- L’indexation manuelle convient aux petits fonds où la précision prime sur le volume.
- L’assistance semi-automatique accélère le travail sans retirer le contrôle humain.
- La classification automatique par IA devient pertinente dès que le volume dépasse la capacité d’une équipe dédiée.
La gouvernance repose sur un comité éditorial qui tranche les ajouts de termes et planifie des cycles de révision réguliers, plutôt que de laisser chaque service enrichir l’arbre à sa façon.
| Indicateur de suivi | Ce qu’il révèle |
|---|---|
| Fréquence d’utilisation des termes | Identifie les branches mortes de l’arbre à élaguer |
| Taux de non-correspondance | Signale les termes ambigus mal compris par les utilisateurs |
| Nombre de demandes d’ajout de terme | Indique où la taxonomie ne couvre pas encore le métier |
Ces indicateurs transforment la taxonomie en objet vivant plutôt qu’en cimetière documentaire qu’on consulte une fois et qu’on abandonne.
Pourquoi capturer le savoir tacite accélère la construction d’une taxonomie
Le corpus documentaire formel ne révèle jamais tout le vocabulaire qu’une équipe emploie réellement. Les libellés métiers, les synonymes maison et les contextes d’usage précis vivent souvent dans la tête des experts, pas dans les procédures écrites.
- Une interview d’expert révèle des termes et des exceptions absents de tout document existant.
- Les procédures d’offboarding bénéficient particulièrement de cette captation avant un départ.
- Les bonnes pratiques non formalisées enrichissent la granularité des termes plus finement qu’une simple relecture de corpus.
L’extraction de termes depuis des entretiens réduit souvent le taux de non-correspondance observé lors des tests d’indexation, car elle anticipe le vocabulaire que les utilisateurs emploieront spontanément. C’est précisément ce que permet notre fonctionnement de captation et de restitution, pensé pour transformer un échange oral en matière exploitable pour un référentiel documentaire.
Ce que l’on sous-estime dans la construction d’une taxonomie
La plupart des guides sur la taxonomie documentaire traitent la question comme un exercice de modélisation : définir des niveaux, choisir une norme, caler un outil. Cette approche néglige une réalité simple : les meilleurs termes d’un référentiel ne viennent presque jamais du corpus écrit, mais de la bouche des personnes qui font le travail.
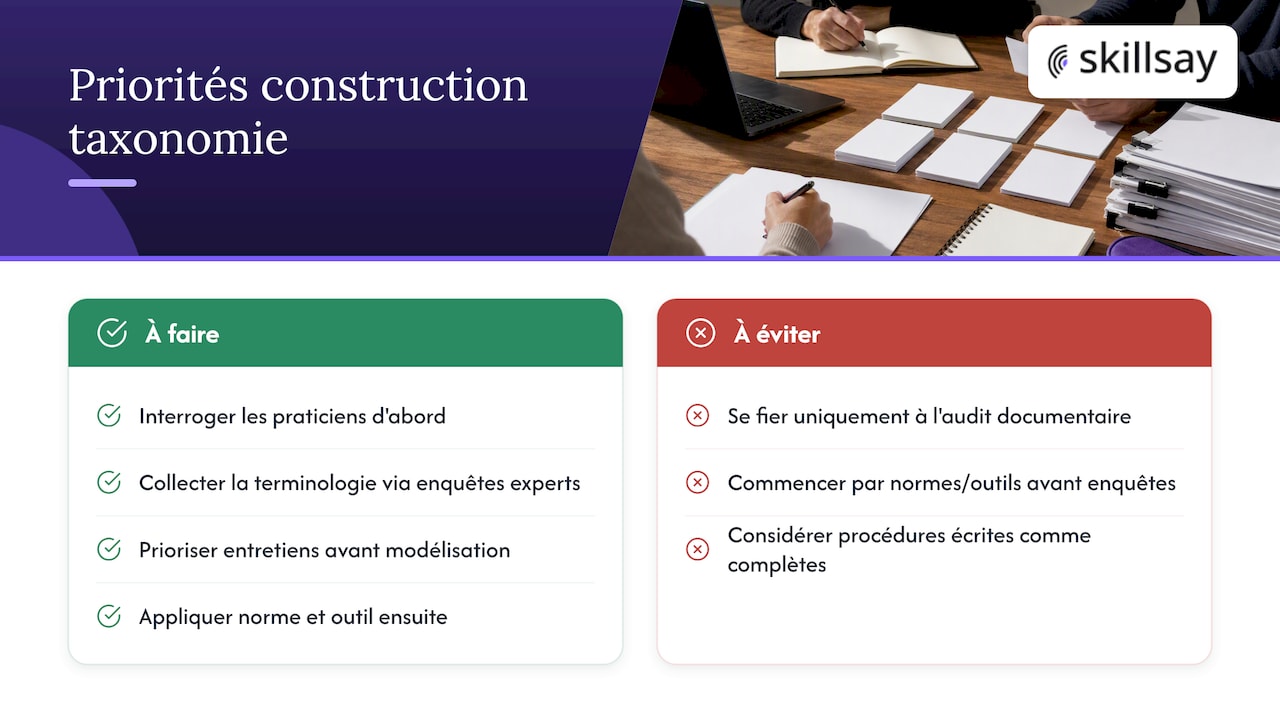
Un audit de documents donne une structure correcte mais appauvrie, parce que les procédures écrites gomment les nuances, les raccourcis et les exceptions que les experts gèrent sans jamais les noter. La priorité devrait donc s’inverser : interroger les praticiens avant de modéliser l’arbre, pas après.
Ce que nous recommandons concrètement : traiter la phase de collecte terminologique comme une enquête auprès des experts métier, et non comme une relecture de documents existants. La norme et l’outil viennent ensuite structurer ce que l’entretien a révélé, jamais l’inverse.
— quentin
Capturer les termes et relations qui manquent à votre taxonomie
Construire une taxonomie documentaire fiable suppose de recueillir un vocabulaire que les documents existants ne contiennent pas toujours. Une IA vocale peut interroger vos experts métier pour extraire les termes, synonymes et expressions de pratique qui structurent réellement leur travail, au moment précis où un inventaire terminologique ou une validation de glossaire s’impose.
Contrairement à une relecture de corpus ou à un atelier de modélisation classique, cette méthode capte un vocabulaire qui n’a jamais été écrit nulle part, avant qu’il ne disparaisse avec un départ ou une réorganisation. Pour voir comment une interview structure ce savoir en matière exploitable pour votre référentiel, consultez notre page produit sur l’interview IA d’experts.
Questions fréquentes
Quels sont les différents types de documentation ?
La documentation se répartit généralement entre documentation de référence (manuels, normes), documentation de procédure (modes d’emploi, processus métier) et documentation de connaissance tacite (retours d’expérience, bonnes pratiques non écrites). Une taxonomie documentaire cherche justement à organiser ces trois types sous un même vocabulaire contrôlé.
Quel est l’ordre des rangs en taxonomie ?
Une taxonomie s’organise du concept le plus général vers le plus spécifique, chaque niveau se rattachant à un seul parent dans une logique de relations génériques et spécifiques.
C’est quoi la classification ?
La classification documentaire désigne l’opération systématique de répartition des documents en catégories selon des critères logiques, le plan de classement en étant l’application concrète, comme le rappelle l’entrée Wikipédia sur la classification de documents. Une taxonomie fournit le vocabulaire, la classification l’applique au classement réel des fonds.
Qu’est-ce qu’un langage documentaire ?
Un langage documentaire est un vocabulaire contrôlé, comme une taxonomie ou un thésaurus, conçu pour représenter de façon normalisée le contenu des documents afin d’en faciliter l’indexation et la recherche. Il réduit les ambiguïtés du langage naturel en imposant un terme préférentiel par concept.
Faut-il utiliser une taxonomie ou un thésaurus pour un petit fonds documentaire ?
Pour un fonds modeste et homogène, une taxonomie simple suffit généralement car elle reste plus légère à maintenir qu’un thésaurus complet. Un thésaurus devient pertinent dès que le besoin de gérer synonymes et relations associatives dépasse les capacités d’une hiérarchie unique, comme le prévoit la norme ISO 25964.
Sources
Pour vérifier ou approfondir ces repères, les textes de référence restent ISO 25964, les vocabulaires contrôlés d’EU Vocabularies et les publications de l’ENSSIB sur le thésaurus INRAE, ainsi que le thésaurus de paléoclimatologie Paleosaurus.
- EU Vocabularies — Taxonomies
- ISO 25964-1:2011 — Thesauri and interoperability
- Révéler et valoriser vos données avec le thésaurus INRAE — ENSSIB
Recommandations
- Savoir tacite en entreprise : comment capturer ce qui n’a jamais été écrit
- Gestion du savoir en entreprise : pourquoi votre base documentaire est déjà morte (et comment la rendre vivante)
- Skillsay IA : l’IA qui interroge le savoir de votre entreprise
- Comptes-rendus de réunions IA qui nourrissent votre base de connaissances