Base SAV intelligente : comment la construire sur un socle de connaissances fiable
Une base SAV intelligente centralise votre savoir métier, alimente des agents IA agentiques et réduit le temps de traitement tout en augmentant la résolution au premier contact. Cette performance dépend d’une condition stricte : une gouvernance documentaire maîtrisée, une validation humaine systématique et une conformité réglementaire anticipée. Sans ce socle, l’IA amplifie les erreurs au lieu de les corriger. La feuille de route qui suit détaille comment construire ce socle, étape par étape.
En bref:
- Nommez un responsable des connaissances et auditez les formats, les propriétaires, les dates de mise à jour, l’accessibilité et l’indexabilité des documents.
- Le diagnostic prend trois à six mois, mais une organisation déjà mûre peut lancer en six à huit semaines un pilote sur deux ou trois cas.
- Mesurez dès le pilote le délai moyen de traitement, la résolution au premier contact et les escalades, puis n’élargissez le périmètre qu’après validation des objectifs.
- Isolez la mémoire de chaque agent, limitez les actions sensibles et exigez une validation humaine; un responsable doit aussi réviser les contenus chaque trimestre.
- Depuis le 2 août 2026, les systèmes conversationnels doivent signaler leur nature automatisée, tandis que les systèmes existants doivent marquer les contenus générés d’ici au 2 décembre 2026.
Table des matières
- Qu’est-ce qu’une base SAV intelligente et en quoi elle dépasse le chatbot
- Pourquoi commencer par le knowledge management : diagnostic de maturité
- Architecture et composants d’une base SAV intelligente
- Comment déployer une base SAV intelligente en douze mois
- Mesurer l’impact : KPIs, suivi et tableau de bord
- Conformité, sécurité et protection des données pour une base SAV intelligente
- Pourquoi la captation du savoir tacite change la donne
- Former les équipes à l’usage quotidien de la base SAV intelligente
- Maintenir la pertinence des connaissances dans le temps
- Impact sur la satisfaction client et la résolution des tickets
- Perspective : comment prioriser en douze mois
- Skillsay pour capturer le savoir tacite et nourrir votre base SAV
- Questions fréquentes
- Sources
Qu’est-ce qu’une base SAV intelligente et en quoi elle dépasse le chatbot
Un chatbot classique répond à des questions à partir d’un script ou d’un arbre de décision figé. Une base SAV intelligente fonctionne différemment : elle s’appuie sur des agents IA capables de raisonner, d’enchaîner plusieurs actions et de mobiliser des sources documentaires variées pour produire une réponse contextualisée. On parle d’IA agentique lorsque le système ne se contente plus de répondre, mais orchestre une séquence de tâches : consulter un historique client, croiser plusieurs documents de référence, vérifier une condition contractuelle, puis rédiger une réponse adaptée au cas précis.
Concrètement, un agent de ce type peut :
- Identifier la nature exacte d’une demande et la router vers le bon processus de traitement.
- Consulter simultanément une fiche produit, une politique de garantie et l’historique du client avant de formuler une réponse.
- Rédiger une réponse personnalisée en respectant le ton et les contraintes réglementaires propres à l’entreprise.
- Déclencher une action dans un système tiers, comme l’ouverture d’un ticket de remboursement ou la planification d’une intervention.
Cette capacité d’orchestration change la nature du projet. Un chatbot traditionnel se construit autour d’un ensemble de questions-réponses prédéfinies, ce qui limite sa pertinence dès que la demande sort du script. Une base SAV intelligente, elle, s’appuie sur une base de connaissances unique, interrogeable par plusieurs agents et plusieurs canaux à la fois : voix, chat, e-mail, interface interne pour les conseillers. Cette unicité évite l’écueil classique des systèmes cloisonnés, où chaque canal développe sa propre version de la vérité et où les réponses finissent par se contredire.
La différence se joue donc moins dans la sophistication du modèle de langage que dans la qualité et la structure des connaissances qui l’alimentent. Un agent agentique branché sur une base de connaissances incohérente produira des réponses incohérentes, quelle que soit la puissance du modèle sous-jacent. C’est pourquoi la question du knowledge management précède, logiquement, celle du choix technologique.
Pourquoi commencer par le knowledge management : diagnostic de maturité
La tentation est grande de déployer un agent IA avant d’avoir assaini sa documentation. C’est pourtant l’ordre inverse qui fonctionne. Le knowledge management gouverné, avec validation humaine, alertes d’obsolescence et boucle de feedback terrain, constitue le pivot d’une IA SAV fiable, et son absence génère des réponses inconsistantes qui finissent par éroder la confiance des équipes et des clients, comme le souligne RelationClientMag.
Un diagnostic de maturité documentaire évalue plusieurs critères avant tout déploiement :
- Formats : les contenus existent-ils sous forme structurée (fiches, procédures) ou dispersés dans des e-mails et des fichiers isolés ?
- Structuration : chaque document a-t-il un propriétaire identifié, une date de mise à jour et un périmètre d’usage clair ?
- Accessibilité : les contenus sont-ils centralisés ou répartis entre plusieurs outils sans passerelle commune ?
- Indexabilité : les documents sont-ils exploitables par un moteur de recherche sémantique, ou nécessitent-ils un retraitement avant ingestion ?
Ignorer ce diagnostic expose à un risque concret : des données non gouvernées produisent des hallucinations, des réponses contradictoires selon le canal, et une perte de confiance des conseillers envers l’outil lui-même. L’enjeu n’est pas seulement technique, il est organisationnel : sans workflow de validation humaine, personne n’arbitre entre deux versions divergentes d’une même procédure.
Cette validation ne s’arrête pas à la mise en production. Une boucle de feedback terrain, où les conseillers signalent une réponse erronée ou une information obsolète, permet de transformer la connaissance en flux vivant plutôt qu’en stock figé. C’est cette vivacité qui réduit l’obsolescence progressive des réponses IA et maintient la pertinence du système dans la durée, selon RelationClientMag.
Conseil de pro : Avant de choisir un outil, faites auditer vingt tickets récents par un conseiller senior pour mesurer l’écart entre ce que dit la documentation officielle et ce qu’il fait réellement sur le terrain : cet écart révèle l’ampleur du chantier à venir.
Architecture et composants d’une base SAV intelligente
Une base SAV intelligente robuste repose sur plusieurs briques techniques qui travaillent ensemble plutôt qu’un modèle unique censé tout résoudre. Les déploiements efficaces utilisent des architectures multi-agents où chaque agent dispose d’un périmètre limité et d’une mémoire dédiée, ce qui évite les fuites d’information et les incohérences de raisonnement, selon Journal du Net.
Les composants typiques d’une telle architecture incluent :
- Un agent classificateur, qui identifie la nature de la demande et détermine le chemin de traitement adapté.
- Un agent spécialiste, qui mobilise les connaissances d’un domaine précis (garantie, facturation, livraison) sans empiéter sur les autres périmètres.
- Un agent rédacteur, qui formule la réponse finale en respectant le ton et les contraintes de l’entreprise.
- Un agent critique, qui relit et valide la cohérence de la réponse avant diffusion, un rôle qui réduit sensiblement le risque d’erreur silencieuse.
Cette architecture s’appuie généralement sur une technique de récupération augmentée (le système va chercher l’information pertinente dans une base documentaire avant de générer une réponse), couplée à une indexation rigoureuse des sources certifiées. Seules les sources validées par le knowledge owner alimentent les agents, ce qui limite le risque de réponses fondées sur des documents obsolètes ou non approuvés.
L’intégration avec l’écosystème existant conditionne l’adoption réelle du projet. Un agent SAV performant se connecte au CRM pour accéder à l’historique client, aux canaux voix et chat pour couvrir l’ensemble des points de contact, et expose une API pour s’intégrer aux outils collaboratifs déjà en place. Sans cette orchestration multicanal, chaque interface développe sa propre version de la connaissance, ce qui recrée précisément le problème que l’architecture unifiée cherchait à résoudre.
Dans une architecture agentique robuste, la mémoire des agents reste cloisonnée et certaines actions à risque exigent une validation humaine ou un niveau d’autorisation spécifique, une conception qui réduit l’exposition aux fuites de données et aux modifications non souhaitées, comme le précise la CNIL dans sa note sur l’IA agentique.
Réduire les risques d’hallucination passe donc par trois leviers combinés : délimiter strictement le périmètre de chaque agent, n’indexer que des sources certifiées et maintenues, et instaurer un contrôle d’accès différencié selon la sensibilité de l’action demandée. Ces garde-fous ne ralentissent pas le système, ils le rendent exploitable en production sans surveillance constante.
Comment déployer une base SAV intelligente en douze mois
La réussite d’un tel projet tient moins à la technologie choisie qu’à l’ordre des étapes. Les projets aboutis suivent une séquence précise : connaissance, puis cas d’usage, puis intelligence artificielle, jamais l’inverse, selon Smart Tribune.
- Phase 0, cadrage stratégique (quelques semaines) : définir les objectifs business prioritaires (réduction du temps de traitement, amélioration du NPS, baisse des escalades), désigner un sponsor dirigeant et nommer un knowledge owner responsable de la validité des contenus.
- Phase 1, diagnostic KM (3 à 6 mois en moyenne) : auditer les formats, la structuration et l’accessibilité documentaire pour établir un score de maturité exploitable, qui guide ensuite le plan de nettoyage et d’enrichissement, selon Smart Tribune.
- Phase 2, priorisation et pilote : classer les cas d’usage selon un rapport impact sur effort, retenir les deux ou trois scénarios les plus rentables à court terme, puis construire un pilote circonscrit à un canal ou une famille de demandes.
- Phase 3, mesure et montée en charge : évaluer les résultats du pilote sur des KPI définis en amont, ajuster la gouvernance si nécessaire, puis étendre progressivement le périmètre à d’autres canaux ou d’autres familles de tickets.
Les organisations déjà matures sur le plan documentaire peuvent lancer un premier cas d’usage en six à huit semaines, tandis que celles partant d’un existant fragmenté comptent plutôt trois à six mois de structuration avant d’activer leurs premiers agents, selon Smart Tribune. Cette variation d’échéance dépend directement de l’état du diagnostic initial, pas de la complexité technique du projet.
Chaque phase se conclut par un point de décision explicite : poursuivre, ajuster le périmètre ou interrompre si les KPI ne sont pas au rendez-vous. Cette discipline évite l’écueil classique du projet IA qui s’étire indéfiniment sans jamais produire de valeur mesurable. Un dirigeant qui commande ce type de projet gagne à exiger un livrable concret à l’issue de chaque phase : un score de maturité documenté, un rapport de priorisation chiffré, un pilote évalué sur des métriques précises.
Conseil de pro : Fixez dès la phase 0 un seuil de décision chiffré (par exemple, un gain minimal de 15 points sur le taux de résolution au premier contact) pour que le passage du pilote à la montée en charge ne dépende pas d’une impression, mais d’un chiffre validé collectivement.
Pour visualiser des cas d’usage déjà déployés dans des organisations comparables, notre article sur les agents IA en entreprise à fort ROI détaille plusieurs scénarios de priorisation.
Mesurer l’impact : KPIs, suivi et tableau de bord
Un déploiement réussi se juge sur des indicateurs précis, suivis dans la durée plutôt qu’à l’occasion d’un bilan ponctuel. Trois métriques opérationnelles forment le socle minimal :
- Le temps moyen de traitement, qui mesure directement le gain de productivité des conseillers.
- Le taux de résolution au premier contact, révélateur de la pertinence des réponses générées par les agents.
- Le volume d’escalade vers un conseiller humain, qui indique les limites actuelles du périmètre automatisé.
À ces indicateurs opérationnels s’ajoutent des métriques de gouvernance : le taux d’articles effectivement utilisés par les agents, le nombre de corrections apportées après signalement, et l’évolution du NPS ou du CSAT dans le temps. Les organisations qui industrialisent un knowledge management piloté par IA observent des améliorations mesurables sur ces deux derniers indicateurs, ainsi qu’une réduction des contacts répétés, selon CXO-at-work.
Les dispositifs de knowledge management pilotés par IA réduisent significativement le temps passé à chercher l’information, un gain qui se traduit directement en capacité de traitement supplémentaire pour les équipes, selon les benchmarks rapportés par CXO-at-work.
La fréquence de revue de ces tableaux de bord mérite d’être fixée dès le lancement du pilote, idéalement de manière hebdomadaire durant les premières semaines, puis mensuelle une fois le système stabilisé. La responsabilité du suivi revient naturellement au knowledge owner, qui arbitre les corrections à apporter et signale au comité de pilotage tout écart significatif par rapport aux objectifs fixés en phase 0.
Conformité, sécurité et protection des données pour une base SAV intelligente
Le cadre réglementaire européen encadre désormais directement les systèmes conversationnels qui interagissent avec des personnes. Depuis le 2 août 2026, l’AI Act impose des obligations de transparence pour ces systèmes, et les systèmes existants devront se conformer au marquage des contenus générés d’ici le 2 décembre 2026, selon Service-public. Concrètement, un agent IA qui répond à un client doit signaler sa nature automatisée, une obligation qui concerne directement toute base SAV intelligente déployée sur un canal client.
Sur le plan technique, les recommandations européennes portent sur l’implémentation de mécanismes de détection et de marquage des contenus générés par IA, ainsi que des tests de robustesse menés en continu plutôt qu’au seul moment du déploiement, selon la Commission européenne.
Côté protection des données, la CNIL formule trois recommandations structurantes pour tout projet d’IA agentique :
- Cloisonner les mémoires de chaque agent pour éviter qu’une information sensible circule au-delà de son périmètre d’usage prévu.
- Limiter l’autonomie des agents sur les actions à fort impact, en exigeant une validation humaine explicite avant exécution.
- Maintenir une supervision humaine continue plutôt qu’un contrôle ponctuel à la mise en production.
La CNIL alerte sur le fait que l’IA agentique complexifie la conformité au RGPD, précisément parce que la multiplication des agents et des mémoires augmente les points d’exposition potentiels, selon sa note dédiée. Sur le plan opérationnel, cela se traduit par des mesures concrètes : isolement technique des environnements sensibles (sandboxing), contrôle d’accès différencié selon les profils utilisateurs, et politique de conservation des données clairement définie et documentée. Notre article sur RGPD et IA générative détaille les vérifications à mener par les dirigeants en amont de tout déploiement.
Pourquoi la captation du savoir tacite change la donne
La plupart des bases de connaissances échouent pour une raison simple : elles ne contiennent que ce qui a été écrit, jamais ce que les meilleurs experts savent faire sans y penser. Les méthodes, les astuces de terrain, le raisonnement qui permet de trancher un cas ambigu en quelques secondes : ce savoir reste dans la tête des collaborateurs les plus expérimentés, jamais couché sur le papier.
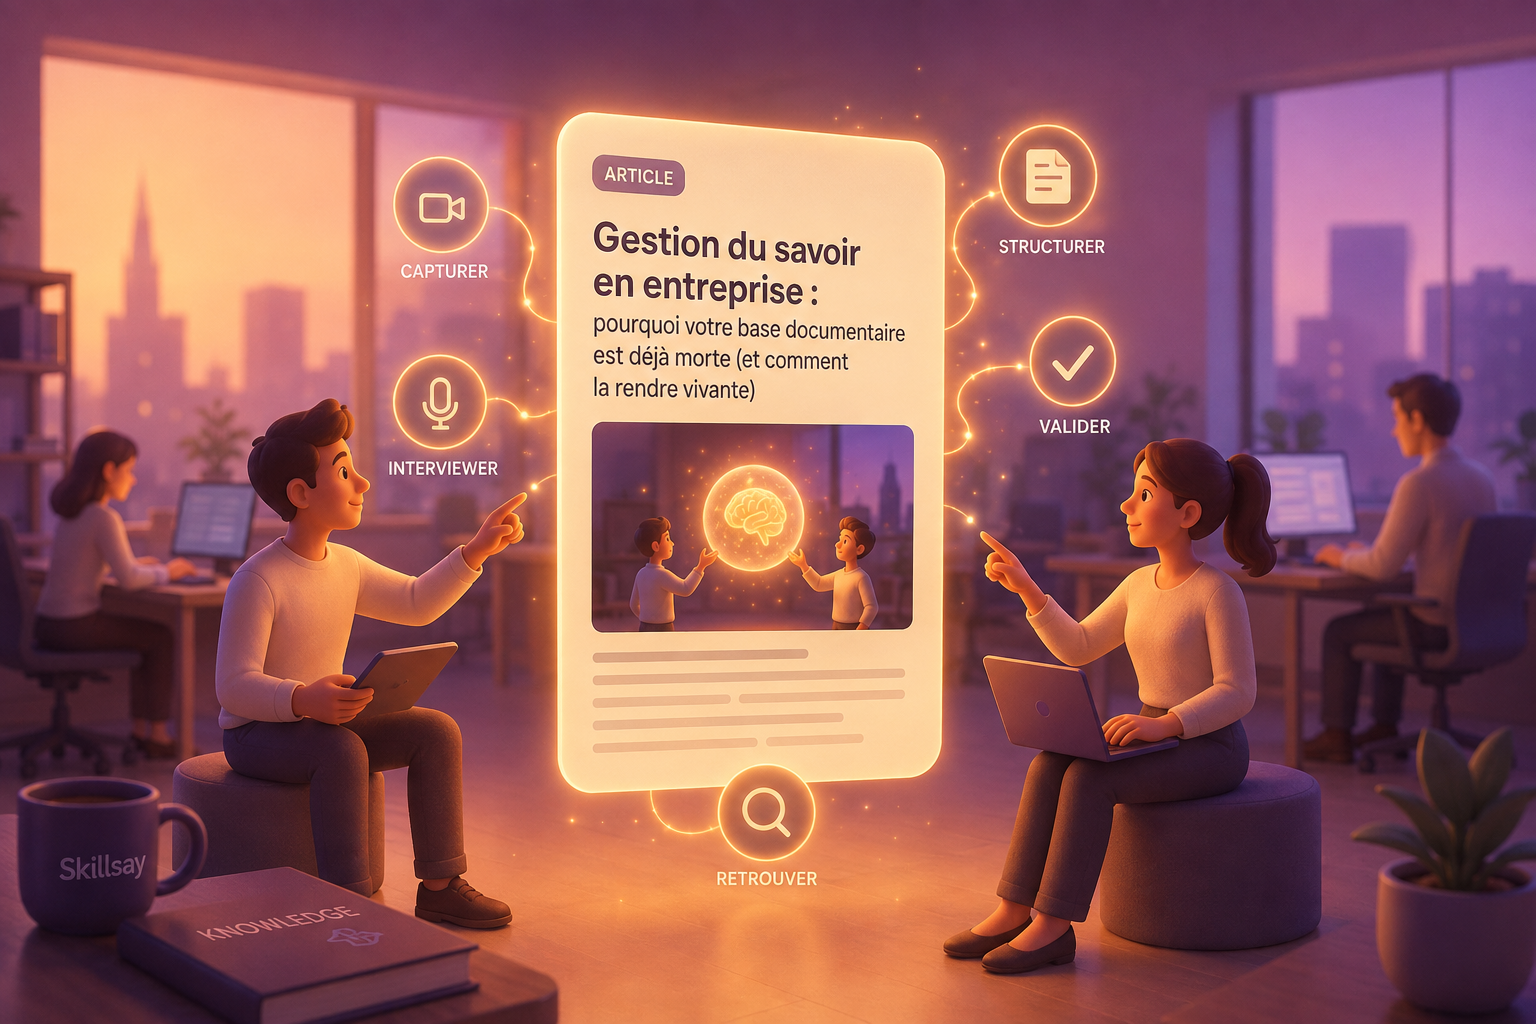
Notre approche consiste à interviewer directement ces experts à l’oral, grâce à Olivia, notre IA vocale conçue pour poser les questions qui révèlent ce savoir implicite. Le processus se déroule en quatre temps :
- Captation : Olivia mène un entretien structuré avec l’expert, en creusant les points où le raisonnement tacite fait la différence.
- Structuration : les échanges sont transformés en contenus exploitables, organisés par thématique et par cas d’usage.
- Validation : un relecteur humain confirme la justesse et l’actualité des contenus avant leur intégration.
- Ingestion : les connaissances validées rejoignent la base documentaire et deviennent accessibles aux agents IA.
Cette démarche trouve une utilité immédiate dans trois situations fréquentes : sécuriser un départ ou un départ à la retraite avant que le savoir ne disparaisse avec la personne, créer des articles de connaissance validés sur des sujets jamais documentés jusque là, et entraîner des agents IA sur des cas qu’aucun document officiel ne couvrait auparavant.
Dans la feuille de route décrite plus haut, cette captation s’intègre naturellement dès la phase de diagnostic : elle vient combler les trous identifiés dans le score de maturité documentaire, avant même le lancement du pilote. Elle continue ensuite d’alimenter la base à mesure que de nouveaux cas d’usage émergent lors de la montée en charge.
Former les équipes à l’usage quotidien de la base SAV intelligente
Un outil parfaitement structuré reste inutile si les conseillers ne savent pas s’en servir au quotidien. La formation ne se limite pas à une session de présentation initiale : elle doit couvrir trois dimensions distinctes. D’abord, la prise en main technique de l’interface, souvent rapide puisque la plupart des agents conversationnels reprennent des logiques familières de messagerie ou de recherche. Ensuite, la compréhension des limites du système, quand faire confiance à une réponse générée et quand escalader vers un collègue plus expérimenté.
La troisième dimension, souvent négligée, concerne la contribution active des conseillers à la base de connaissances. Un conseiller qui repère une réponse erronée ou une information obsolète doit disposer d’un circuit simple pour la signaler, sans quoi la boucle de feedback terrain reste théorique. Former les équipes à ce rôle de contributeur, et pas seulement d’utilisateur, conditionne la fiabilité du système dans la durée.
L’accompagnement gagne à s’appuyer sur des référents identifiés par équipe, capables de répondre aux questions courantes et de remonter les difficultés récurrentes au knowledge owner. Cette présence de proximité réduit les résistances naturelles au changement, surtout chez les conseillers les plus expérimentés qui peuvent percevoir l’outil comme une remise en cause de leur expertise, alors qu’il s’agit au contraire de la valoriser et de la diffuser plus largement.
Maintenir la pertinence des connaissances dans le temps
Une base de connaissances n’est jamais un projet terminé. Les produits évoluent, les procédures changent, les réglementations se mettent à jour : sans mécanisme d’actualisation continue, la base se dégrade silencieusement jusqu’à devenir une source d’erreurs plutôt qu’une aide.
Transformer la connaissance en flux vivant plutôt qu’en stock figé passe par des alertes d’obsolescence automatiques, qui signalent les contenus non révisés depuis une période définie, et une boucle de feedback terrain où chaque signalement de conseiller déclenche une vérification, selon RelationClientMag. Cette vivacité évite l’écueil du cimetière documentaire, où des centaines d’articles s’accumulent sans que personne ne sache lesquels restent valides.
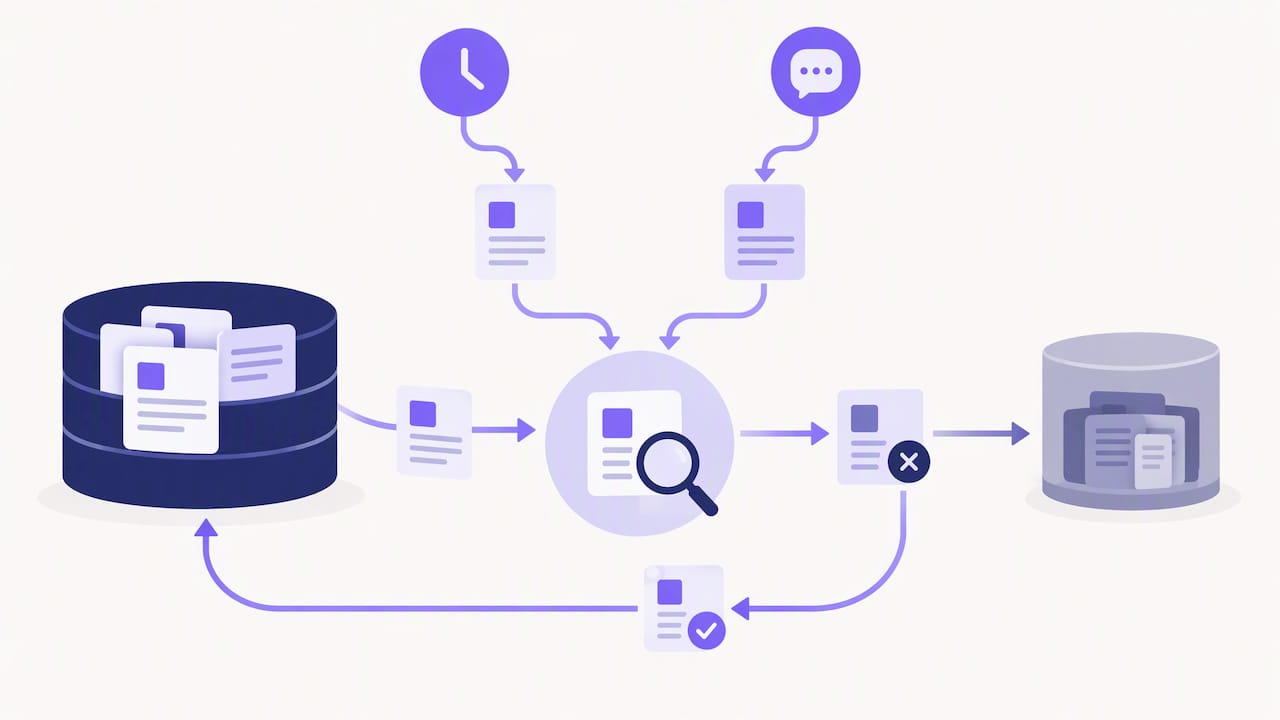
La responsabilité de cette maintenance revient au knowledge owner, dont le rôle dépasse la simple validation initiale : il arbitre les mises à jour, tranche les versions contradictoires et décide de l’archivage des contenus devenus obsolètes. Le succès technique d’un tel dispositif dépend moins du modèle d’IA choisi que de cette gouvernance humaine continue, selon la CNIL.
Un rythme de révision trimestriel, couplé à des alertes automatiques déclenchées par l’usage réel (articles jamais consultés, articles systématiquement corrigés), permet de concentrer l’effort de maintenance là où il compte vraiment plutôt que de réviser uniformément l’ensemble de la base.
Impact sur la satisfaction client et la résolution des tickets
L’objectif final de toute base SAV intelligente reste la qualité perçue par le client, pas la sophistication technique du dispositif. Deux effets se conjuguent habituellement. Le premier concerne la vitesse : un conseiller qui retrouve l’information pertinente en quelques secondes, plutôt qu’en plusieurs minutes de recherche dans des documents dispersés, traite davantage de demandes dans le même temps et réduit l’attente perçue par le client.
Le second effet concerne la cohérence. Lorsque la base de connaissances est unique et correctement gouvernée, un client obtient la même réponse qu’il passe par le chat, le téléphone ou l’e-mail, ce qui renforce la confiance envers l’entreprise plus que la rapidité seule. Les organisations qui structurent leur knowledge management autour de l’IA observent des gains mesurables sur le NPS et le CSAT, ainsi qu’une baisse des contacts répétés pour un même motif, selon CXO-at-work.
Ces deux effets se renforcent mutuellement dans la durée : une base fiable réduit les escalades, ce qui libère du temps pour traiter les cas réellement complexes avec l’attention qu’ils méritent, ce qui améliore à son tour la perception globale du service. L’inverse est également vrai : une base mal gouvernée génère des réponses incohérentes qui érodent la confiance plus vite qu’un simple délai d’attente ne le ferait.
Perspective : comment prioriser en douze mois
Un dirigeant pressé de voir des résultats a intérêt à résister à la tentation du grand déploiement immédiat. La priorité numéro un reste la gouvernance : nommer un knowledge owner avant de choisir un outil, pas après. La priorité numéro deux est le diagnostic KM, même sommaire, car il évite des mois de corrections ultérieures sur une base mal structurée. Vient ensuite la sélection de deux ou trois cas d’usage à fort retour, mesurés avant toute extension du périmètre.
Le risque principal n’est pas technique, il est organisationnel : laisser l’IA tourner sans validation humaine sur des sujets sensibles. Ce risque se gère simplement, par des garde-fous clairs sur les actions autorisées sans supervision et celles qui l’exigent systématiquement. Les entreprises qui réussissent ce type de projet traitent la captation du savoir tacite comme un investissement continu, pas comme un chantier ponctuel clos après le premier pilote.
— quentin
Skillsay pour capturer le savoir tacite et nourrir votre base SAV
Construire une base SAV intelligente suppose de disposer d’un savoir réellement complet, pas seulement de ce qui figure déjà dans vos documents. Nous proposons une approche différente : Une IA vocale peut interviewer vos experts pour capturer les méthodes, les astuces et le raisonnement qu’aucun document n’a jamais consignés.
Concrètement, ce savoir est structuré et validé avant d’être intégré à une mémoire d’entreprise interrogeable par des agents IA. Cette approche s’adapte à plusieurs situations courantes :
- Offboarding : sécuriser le départ d’un collaborateur expérimenté en captant son savoir avant qu’il ne quitte l’entreprise.
- Onboarding : former les nouvelles recrues sur des pratiques métier qui ne figuraient dans aucun manuel.
- Support multicanal : enrichir une base SAV existante avec des cas de résolution que seuls vos experts les plus chevronnés maîtrisaient jusque là.
Pour le cas spécifique d’un départ à sécuriser, un service d’interview vocale IA pour l’offboarding est proposé avec une tarification par profil. Pour une utilisation continue d’une plateforme de knowledge management augmentée par IA, l’abonnement peut se faire sur la base d’une tarification mensuelle par entité. Pour voir comment ce processus de captation s’intègre concrètement à votre organisation, découvrez comment fonctionne Skillsay ou demandez une démonstration.
Questions fréquentes
Qu’est-ce qui différencie une base SAV intelligente d’une FAQ classique ?
Une FAQ classique propose des réponses figées à des questions anticipées, tandis qu’une base SAV intelligente s’appuie sur des agents IA capables de raisonner sur un cas précis en croisant plusieurs sources. Elle s’adapte à des situations non prévues à l’avance, contrairement à une FAQ qui reste limitée à son script initial.
Combien de temps faut-il pour déployer une base SAV intelligente ?
Le diagnostic documentaire préalable dure généralement de 3 à 6 mois selon Smart Tribune, mais les organisations déjà matures sur le plan documentaire peuvent lancer un premier pilote en 6 à 8 semaines. La durée dépend essentiellement de l’état initial de votre documentation, pas de la complexité technique du projet.
Quelles obligations légales s’appliquent à une base SAV intelligente ?
Depuis le 2 août 2026, l’AI Act impose des obligations de transparence aux systèmes d’IA qui interagissent directement avec des personnes, et les systèmes existants doivent se conformer au marquage des contenus générés d’ici le 2 décembre 2026, selon Service-public. La CNIL recommande en complément le cloisonnement des mémoires et une supervision humaine continue sur les actions sensibles.
Comment capturer le savoir qui n’est écrit dans aucun document ?
Ce savoir tacite, constitué de méthodes, d’astuces et de raisonnements d’experts, s’obtient par interview directe plutôt que par extraction documentaire. Notre IA vocale Olivia mène ces entretiens pour transformer l’expérience orale des collaborateurs en connaissances structurées et validées, intégrables ensuite dans une base de connaissances exploitable par des agents IA.
Quels indicateurs suivre pour mesurer le succès du projet ?
Les indicateurs opérationnels principaux sont le temps moyen de traitement, le taux de résolution au premier contact et le volume d’escalade vers un conseiller humain. S’y ajoutent des indicateurs de gouvernance comme le taux d’articles effectivement utilisés et l’évolution du CSAT ou du NPS dans le temps.
Sources
- Service-public: actualité AI Act / obligations de transparence
- CNIL — Note sur l’IA agentique et la protection des données (2026)
- RelationClientMag — Le KM, moteur indispensable d’une IA réussie pour les conseillers clients