Dédoublonnage de documents : méthodes, règles de fusion et flux de travail fiable
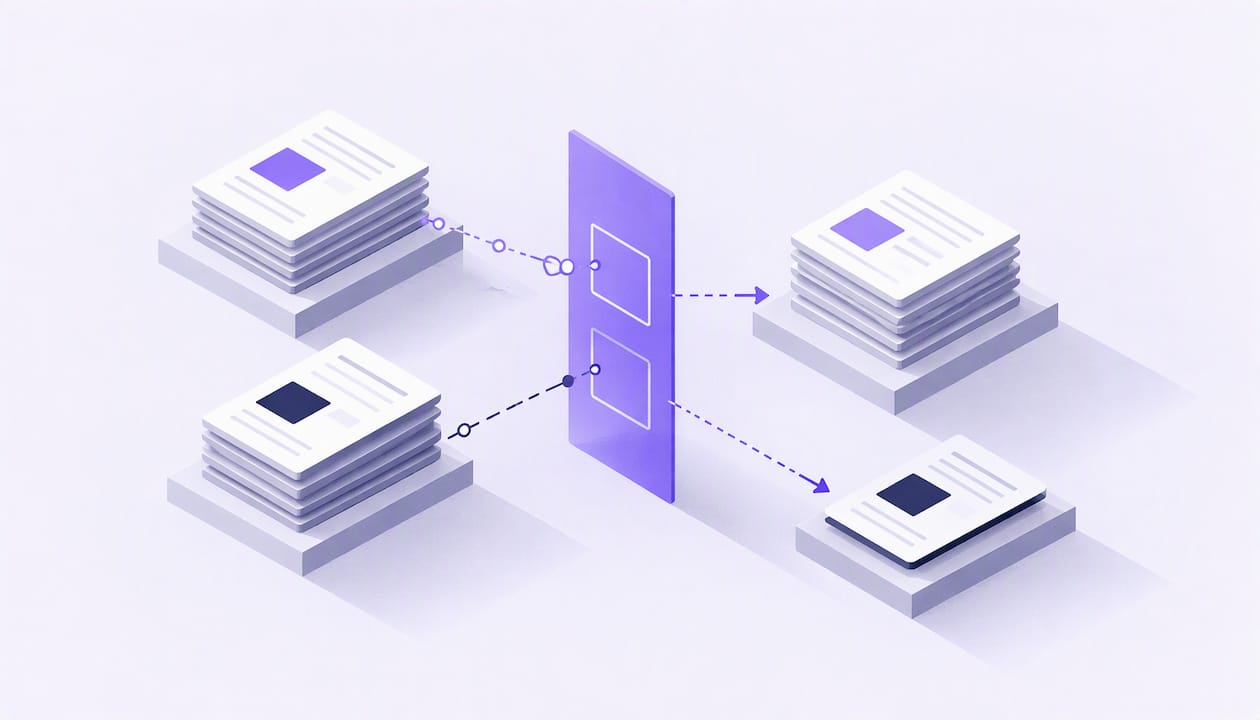
Le dédoublonnage de documents se déroule en deux temps : le matching, qui identifie les doublons, puis le merging, qui fusionne ou hiérarchise les exemplaires retenus. Les checksums repèrent les doublons stricts, les empreintes de similarité attrapent les quasi-doublons. Dans tous les cas, détectez automatiquement, constituez une shortlist, puis faites valider par un humain avant toute fusion ou suppression.
En bref:
- Les sommes de contrôle MD5 repèrent les copies exactes, tandis que simhash et minhash détectent les variantes dues à l’OCR ou aux rééditions.
- Avant toute fusion, sauvegardez les versions originales, transférez les métadonnées uniques et consignez chaque opération afin de pouvoir restaurer les notices en cas d’erreur.
- Des éditions différentes, des droits distincts ou des ressources agrégées peuvent masquer des différences importantes ; gardez les notices séparées pour éviter de compromettre l’accès.
- Pour un grand corpus, contrôlez les nouveaux documents à l’importation et analysez périodiquement le fonds existant, puis ajustez les seuils après chaque audit humain.
Table des matières
- Comment identifier les doublons : identifiants, checksums et empreintes de contenu
- Comment fusionner sans rien perdre : règles de priorisation et traçabilité
- Quels outils et quelles fonctions rechercher pour gérer les doublons
- Quel flux de travail suivre pour dédoublonner à grande échelle
- Quelles bonnes pratiques de gouvernance garantissent un dédoublonnage durable
- Ce que le dédoublonnage ne dit pas : le contexte que personne n’a écrit
- Enrichir et gouverner votre base consolidée avec Skillsay
- Questions fréquentes
- Sources
Comment identifier les doublons : identifiants, checksums et empreintes de contenu
Aucune technique ne couvre seule tous les cas. Vous obtiendrez de bons résultats en les combinant, selon la nature de votre corpus :
- Identifiants et clés normalisées : le matching sur ISBN, DOI ou clé titre/auteur normalisée fonctionne très bien quand les notices sont complètes. Il échoue plus souvent sur les notices lacunaires, typiques d’une rétroconversion.
- Checksums cryptographiques : une empreinte MD5 ou SHA-256 révèle les copies binaires identiques. La BnF recommande de conserver un fichier compagnon .md5 contenant l’empreinte et le chemin d’accès.
- Fingerprints textuels : simhash et min-hash détectent les variantes issues d’un passage OCR ou d’une réédition, là où le checksum ne voit aucune ressemblance. La formalisation par distance d’édition permet aussi de traiter les duplicata partiels ou dégradés.
- Détection visuelle : pour les collections numérisées, on compare des descripteurs locaux d’images avant de vérifier la disposition spatiale des points communs.
Une approche hybride s’impose : checksums pour les doublons exacts, algorithmes de similarité pour les variantes. Un dédoublonnage reposant uniquement sur l’OCR bute sur les erreurs de reconnaissance et les variations de mise en page.
Côté images, un workflow en shortlist suivie d’une vérification spatiale réduit les faux positifs. Quelle que soit la méthode, fixez des seuils de similarité et prévoyez une revue humaine pour tout ce qui se situe dans la zone grise.

Comment fusionner sans rien perdre : règles de priorisation et traçabilité
Détecter un doublon ne dit pas quoi conserver. Pour décider sans détruire d’information, suivez ce cheminement :
- Constituez la shortlist des paires ou groupes candidats, avec le critère qui les a fait remonter.
- Appliquez vos règles de priorisation : en cas de présence conjointe d’un fichier et d’une notice, gardez le fichier ; entre deux notices, retenez la plus ancienne, la plus complète ou la plus conforme aux normes en vigueur, selon votre politique locale. L’ABES/Sudoc préconise d’ailleurs de localiser sous une notice existante plutôt que d’en créer une nouvelle.
- Transférez les métadonnées uniques du doublon écarté vers l’exemplaire conservé.
- Tranchez : fusion physique, cluster logique ou marquage « no-merge ». Quand c’est possible, préférez le cluster logique : certains systèmes avancés reconstruisent une notice riche à chaque mise à jour sans rien perdre des contributions propres à chaque source.
- Journalisez chaque opération pour pouvoir revenir en arrière.
Traitez à la main les cas limites : éditions différentes, jeux de droits distincts, ressources agrégées. Un doublon de description n’est pas toujours un doublon de ressource, et forcer la fusion peut rompre des liens de gestion des droits ou d’accès.
Conseil de pro : avant toute fusion physique, exportez les deux notices ou fichiers dans un dossier de sauvegarde horodaté : la restauration devient triviale si la revue révèle une erreur.
Quels outils et quelles fonctions rechercher pour gérer les doublons
Peu importe le logiciel, certaines fonctions font la différence entre un outil de dédoublonnage utile et un simple détecteur de similitudes :
- une collection ou vue « Doublons » qui regroupe les candidats pour examen ;
- des suggestions automatiques, avec choix entre mode automatique et mode suggestion ;
- une fusion avec hiérarchisation, qui conserve les champs utiles des deux versions ;
- une recherche par identifiant (ISBN, DOI) ;
- un export et une journalisation des opérations réalisées.
Les exemples concrets abondent. Zotero affiche une collection « Doublons » et permet de fusionner les notices candidates, ce qui convient bien à une bibliothèque individuelle. HAL expose une interface d’administration dédiée au dédoublonnage. Le Sudoc, de son côté, privilégie la localisation sous une notice déjà présente plutôt que la création d’un nouvel enregistrement.
Réglez ensuite les paramètres techniques avec soin : champs de comparaison, seuils de similarité, règles de priorisation. Enfin, choisissez le moment de la détection. Contrôler à l’import évite que le problème s’installe, tandis qu’une analyse planifiée en lot assainit le fonds existant. Les deux se complètent, et l’idéal reste de les combiner.
Quel flux de travail suivre pour dédoublonner à grande échelle
Sur un corpus volumineux, l’ordre des opérations compte autant que les outils :
- Normalisation et ingestion : standardisez les métadonnées et extrayez les identifiants (ISBN, DOI) dès l’entrée.
- Détection automatique : appliquez les checksums pour les doublons exacts, puis les fingerprints et mesures de similarité pour les variantes.
- Shortlist et priorisation : classez les candidats selon vos règles définies à l’avance.
- Revue humaine : décidez entre fusion, cluster ou no-merge, en sauvegardant les versions d’origine.
- Audit post-opération : mesurez les faux positifs, les faux négatifs et le taux de réussite pour ajuster vos seuils au prochain cycle.
Cette boucle n’a rien de définitif : chaque audit nourrit la configuration de l’étape 2. Sur des numérisations, documentez aussi les traitements automatiques appliqués aux images : la charte qualité de FranceArchives rappelle qu’ils doivent être maîtrisés et décrits pour éviter toute perte d’information.
Quelles bonnes pratiques de gouvernance garantissent un dédoublonnage durable
Un dédoublonnage réussi se pérennise par des règles écrites, pas par un coup de balai ponctuel :
- Documentez les standards que vous suivez (RDA/FRBR, ISBN, DOI) et entretenez des autorités normalisées. L’harmonisation des autorités et le respect de normes comme UNIMARC ou RDA conditionnent l’efficacité des outils.
- Conservez les checksums (.md5, .sha256) en fichiers compagnons pour détecter toute modification ultérieure.
- Définissez vos règles de priorisation, un code « no-merge » pour les faux doublons confirmés, et un mécanisme de restauration.
- Réunissez DSI, archivistes et responsables métiers pour fixer la politique et programmer des revues périodiques.
- Vérifiez la qualité de vos données en amont : ce cadre de critères de qualité des données se transpose bien à un contrôle préalable au dédoublonnage.
N’automatisez jamais totalement la suite : les spécialistes de la curation rappellent que l’intervention humaine reste nécessaire sur les cas complexes pour ne pas supprimer de métadonnées précieuses. Pour structurer vos champs, notre guide sur la taxonomie documentaire donne des repères utiles, et celui sur la standardisation des bonnes pratiques aide à rédiger vos règles.
Conseil de pro : rédigez la politique de priorisation en une page, signée par les parties prenantes : la première contestation de fusion devient alors une simple lecture de règle.
Ce que le dédoublonnage ne dit pas : le contexte que personne n’a écrit
Un doublon n’est jamais seulement un fichier en trop : derrière deux variantes, il y a souvent deux usages, deux contextes, deux façons de faire que personne n’a documentées. Dédoublonner à l’aveugle, c’est risquer d’écarter la version que les experts utilisent vraiment. À mon sens, la fiabilité d’une consolidation dépend moins de l’algorithme que de ce que l’on sait des usages métier avant de trancher. Capter cette connaissance par la voix, auprès de ceux qui l’ont, évite de supprimer à tort et facilite la revue.
— quentin
Enrichir et gouverner votre base consolidée avec Skillsay
Un corpus dédoublonné reste un corpus muet sur le pourquoi des choses. Avec Olivia, notre IA vocale, nous interviewons vos experts pour capter ce qu’ils savent et qu’aucun document ne dit, puis nous l’associons à vos ressources.
Découvrez comment fonctionne Skillsay ou demandez-nous une démonstration.
Questions fréquentes
Quelle est la définition du dédoublonnage ?
Le dédoublonnage consiste à repérer les documents ou notices qui décrivent la même ressource, puis à n’en conserver qu’une version de référence enrichie. Il se compose de deux étapes : le matching (identification) puis le merging (fusion ou hiérarchisation), selon la méthode décrite en bibliothéconomie.
Comment éliminer les fichiers en double ?
Générez une empreinte numérique (MD5 ou SHA-256) pour chaque fichier et regroupez ceux qui partagent la même valeur. Faites ensuite valider la shortlist par un humain, sauvegardez les originaux, conservez un exemplaire et journalisez la suppression des autres.
Comment savoir si on a des fichiers en double ?
Comparez les checksums pour les copies strictes, puis appliquez une mesure de similarité (simhash, min-hash) pour repérer les variantes proches issues d’OCR ou de rééditions. Ces deux contrôles se complètent, car l’un ne voit pas ce que l’autre détecte.
Comment supprimer les doublons automatiquement ?
Des outils comme Zotero proposent une collection « Doublons » avec fusion assistée. Pour les cas simples, un mode automatique est possible, mais gardez le mode suggestion pour les quasi-doublons, afin de vérifier chaque cas ambigu avant de supprimer.
Sources
- Duplicate Detection for Quality Assurance of Document Image Collections: Paper - iPRES 2012 - Digital Curation Institute, iSchool, Toronto
- Ediscovery-automation